2026年9月22日(米国時間)、AnthropicとOpenAIが同じ日に新モデルを出しました。Anthropicは「Fable 5.1並みの性能を、Opus 5より40%安く」と打ち出したClaude Opus 5.5を発表。同じ日にOpenAIも、9月3日発表の最上位モデルGPT-6 Astraに続いて、低価格のGPT-6 SolとGPT-6 Lunaを投入しました。これでGPT-6シリーズは「Astra・Sol・Luna」の3本立てになっています。
本記事は、GPT-6シリーズとClaude Opus 5.5の「業務でどっちを使うべきか」を、公式ベンチマーク・独立評価・料金・10の業務シーンで整理します。前回(GPT-5.6×Opus 5)の比較から何が逆転したのか、そして両社の数値を並べるときの落とし穴も含め、2026年9月24日時点の情報で比較します。
目次
【結論】GPT-6とOpus 5.5の使い分け早見表
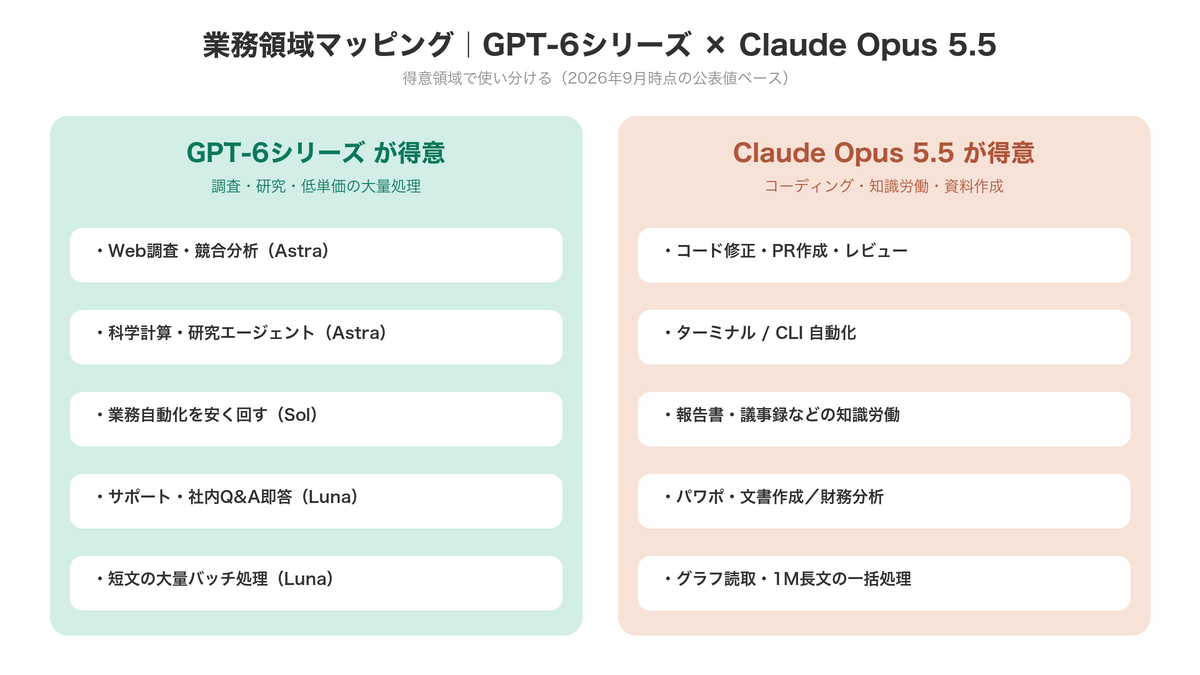
今回の世代交代で、力関係は大きく動きました。コーディング・ターミナル操作・報告書などの知識労働・資料作成ではOpus 5.5がリードし、Web調査・科学研究系のエージェント作業ではGPT-6 Astra、低単価の大量処理ではGPT-6 Sol/Lunaが優位です。前回の比較でGPT-5.6側が持っていた「ターミナル操作」と「知識労働の総合評価」は、Opus 5.5が取り返した形になります。
3秒でわかる使い分け早見表
| 業務タイプ | 推奨モデル | 決定的な理由 |
|---|---|---|
| コード修正・PR作成 | Opus 5.5 | FrontierCode 54.4%(Astra 53.3%)、CursorBench 57.8% |
| ターミナル・CLI自動化 | Opus 5.5 | Terminal-Bench 4.0で66.4%(Astra 57.9%)。ただし第三者測定では両者59.6%前後で互角 |
| 報告書・議事録などの知識労働 | Opus 5.5 | GDPval-AA v2.1で1,846 Elo(Astra 1,542) |
| Excel集計・業務自動化 | 互角(量ならSol) | AutomationBenchはAstra 41.4%/Opus 5.5 40.0%。Solは33.2%を1タスク$0.27で |
| Web調査・競合分析 | GPT-6 Astra | BrowseComp 91.5%(Opus 5.5は未公表) |
| 大量の定型処理(API) | GPT-6 Luna | 入力$0.10/出力$0.50(Opus 5.5の40分の1) |
なぜ「どちらが優れているか」だけでは決められないのか
Opus 5.5は多くの公式ベンチマークでAstraを上回りましたが、業務自動化(AutomationBench)と科学研究系(Terminal-Bench-Science)ではAstraが勝っています。料金面では、Opus 5.5($4/$20)はAstra($10/$50)より安い一方、GPT-6 Sol($2/$10)とLuna($0.10/$0.50)はOpus 5.5よりさらに安いという構図です。加えて、両社が公表する数値は測定条件(推論の深さ・実行環境・安全装置の扱い)がそろっておらず、単純比較が難しい事情もあります(詳細は後述)。導入判断の軸は「自社の主要業務がどちらの得意領域にハマるか」と「実タスクでの検証」です。
Claude Opus 5.5とは?2026年9月22日発表「Fable 5.1並みを4割安く」の中身
Claude Opus 5.5は、Anthropicが2026年9月22日に発表した「Claude 5.5ファミリー」最初のモデルです(APIモデルID:claude-opus-5-5)。公式発表は「多くの作業でClaude Fable 5.1と同水準の性能を出し、実行コストはOpus 5より40%少ない」と位置づけています。GPT-6と比べるときに見ておきたいのは、次の5点です。
- 料金は入力$4/出力$20(100万トークンあたり)。Opus 5($5/$25)から20%下がりました。キャッシュ読み取りは$0.20で、Opus 5から60%下がっています。1タスクあたりの消費トークンも減り、公式は「典型的な業務で40%のコスト減」と説明しています。
- 出力の生成はOpus 5より30%以上速くなっています。最大2.5倍速の「Fastモード」($8/$40)もClaude APIで使えます。
- 思考(thinking)は常にオンです。Opus 5では無効にできましたが、Opus 5.5では切れません。深さは
effort(low〜maxの5段階)で調整し、既定値はOpus 5のhighから1段下のmediumに変わっています。 - コンテキストは1Mトークン、最大出力128Kトークン、知識カットオフは2026年6月。1Mトークンまで長文の割増はありません。
- Claudeの有料プラン(Pro/Max/Team/Enterprise)で利用でき、5時間あたりの利用上限も引き上げられました。Claude Codeでは既定のOpusモデルがOpus 5.5に切り替わっています(Claude Code v2.1.280)。APIはClaude API・Amazon Bedrock・Google Cloud・Microsoft Foundryで提供されます。
なお、Anthropicの最上位モデルClaude Fable 5.1($10/$50)は引き続き提供されています。ただしOpus 5.5は公式表の多くの項目でFable 5.1を上回っており、Anthropic自身も「社内利用ではOpus 5.5とFable 5.1の差はスコアほど大きくない」と述べています。「迷ったらOpus 5.5、最高難度の推論だけFable 5.1」で困る場面は少ないはずです。下位モデルのSonnet 5.5・Haiku 5.5も「今後数週間で」投入予定とされています。
GPT-6シリーズ(Astra/Sol/Luna)とは?3本立ての中身
GPT-6シリーズは、2026年9月3日に最上位のGPT-6 Astraが発表され、9月22日にGPT-6 SolとGPT-6 Lunaが加わりました。GPT-5.6の「Sol/Terra/Luna」の3階層に対し、GPT-6世代は「Astra/Sol/Luna」の3本立てで、Terraに当たるモデルはありません。SolとLunaはAstraと同様の手法で訓練されており、OpenAIは「Astraの進歩を、より速く安いモデルに持ち込んだ」と説明しています。
| モデル | 位置づけ | API料金(入力/出力・100万トークンあたり) | 272K超の入力時 |
|---|---|---|---|
GPT-6 Astra(gpt-6-astra) | 最上位。最も難しい仕事向け | $10/$50 | $20/$75 |
GPT-6 Sol(gpt-6-sol) | 複雑なコーディング・エージェント作業向け | $2/$10 | $4/$15 |
GPT-6 Luna(gpt-6-luna) | 大量の定型タスク向け | $0.10/$0.50 | $0.20/$0.75 |
※出典:OpenAI API料金ページ(2026年9月24日確認)。3モデルともコンテキスト約105万トークン・最大出力128Kトークン。
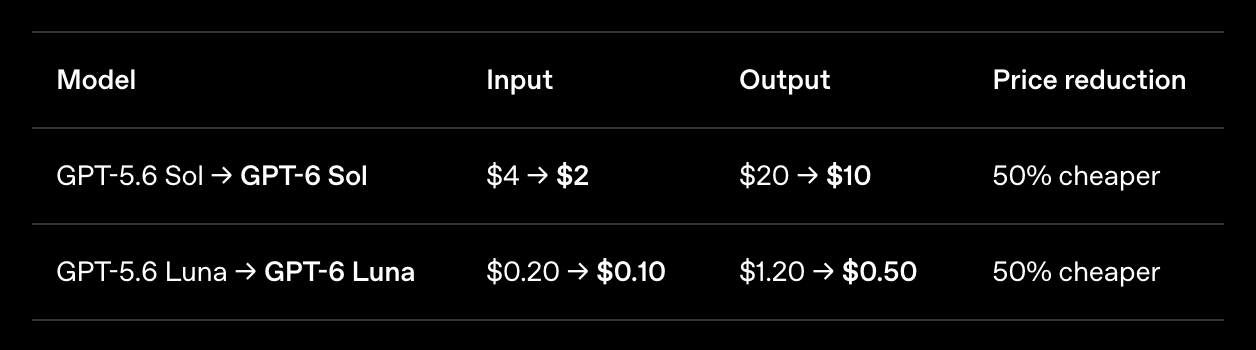
SolとLunaの料金は、GPT-5.6(キャンペーン価格)の半額です。GPT-5.6 Solが$4/$20だったのに対し、GPT-6 Solは$2/$10になりました。キャッシュ読み取りは入力単価の90%引きです。
ChatGPTでは「Work」と「Codex」から提供
ChatGPTでの提供範囲は少し複雑です。SolとLunaは、ChatGPT WorkとCodexでPlus・Pro・Business・Enterprise・Eduの利用者に提供され、FreeとGoの利用者はデスクトップアプリでLunaを使えます。一方、通常のChat画面ではまだ使えません(OpenAI公式発表)。Astraについては、OpenAIヘルプセンターの記載では、通常のChatでは「GPT-6 Pro」の名称でPro($100・$200)・Business・Enterpriseに提供され、PlusはWorkとCodex経由での利用となっています。業務導入の際は、自社アカウントのモデル選択欄で確認してください。
主要ベンチマークで見るGPT-6 vs Opus 5.5の勝敗
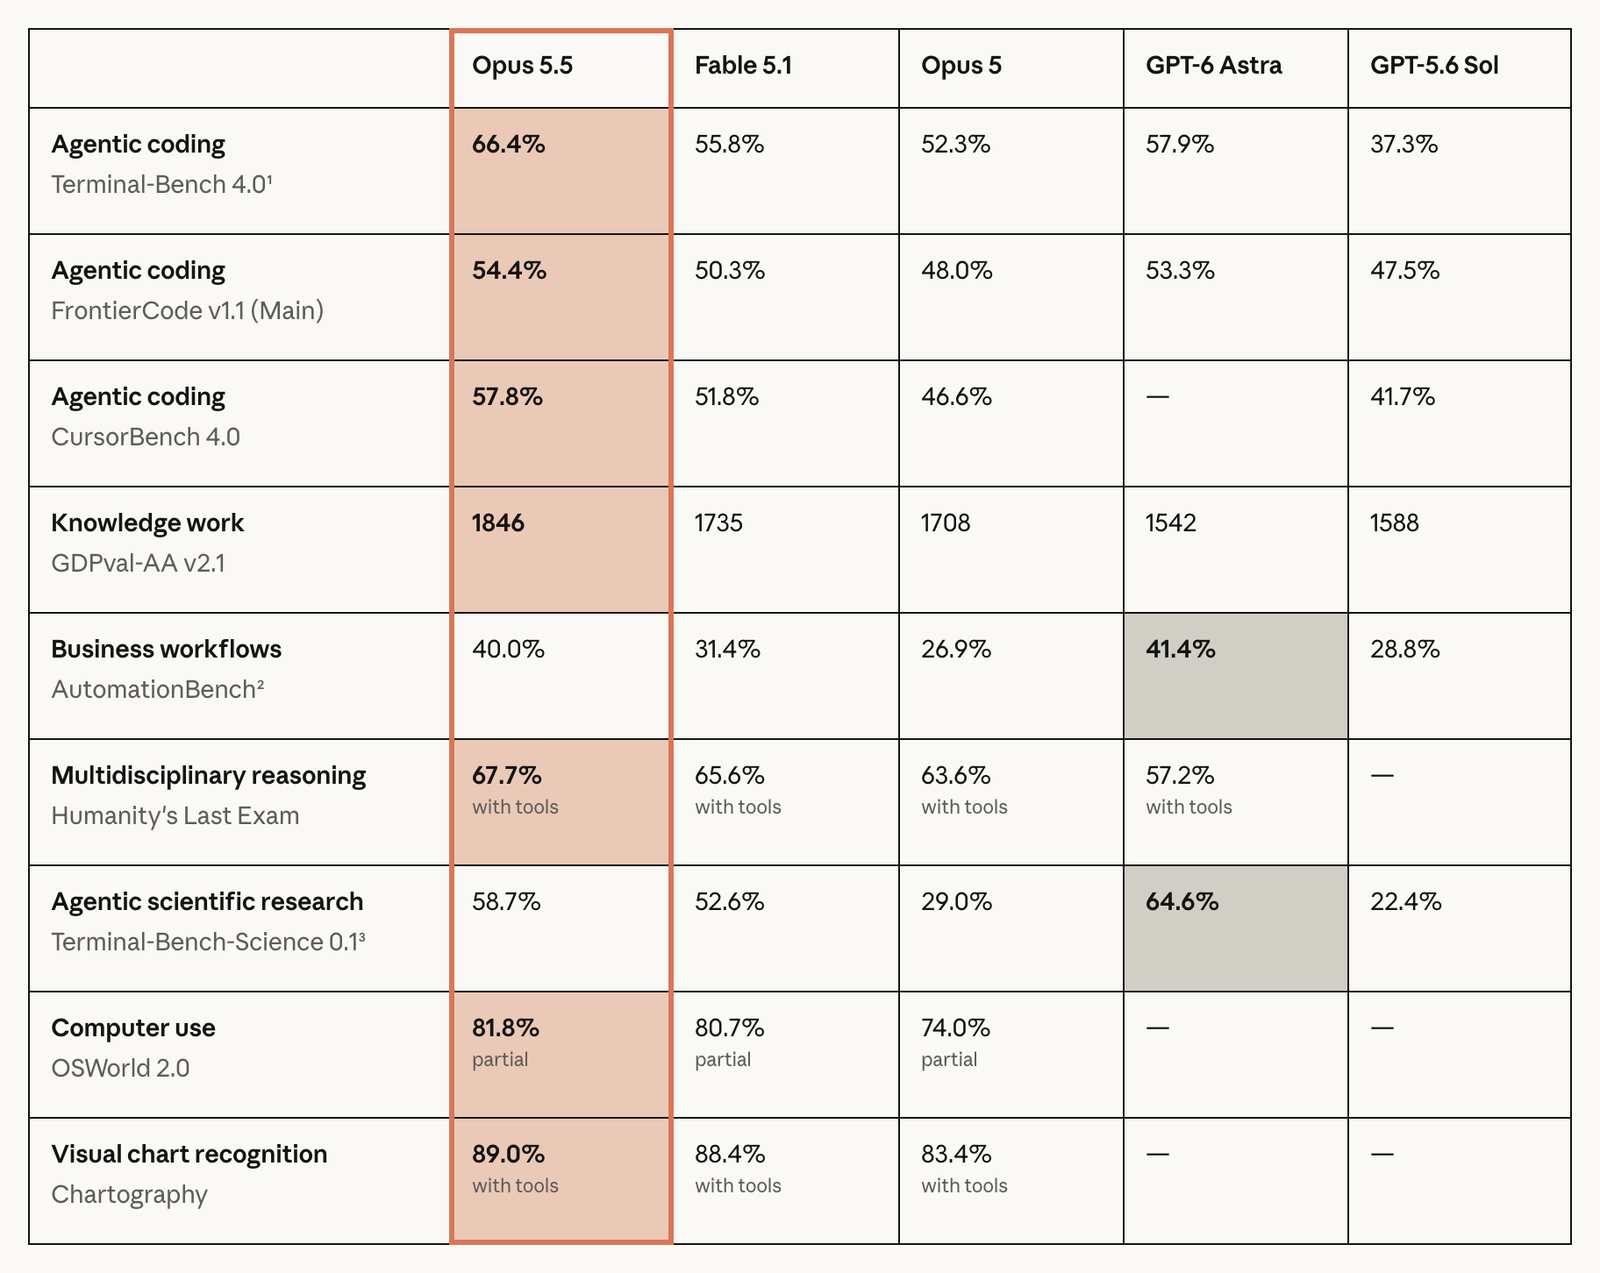
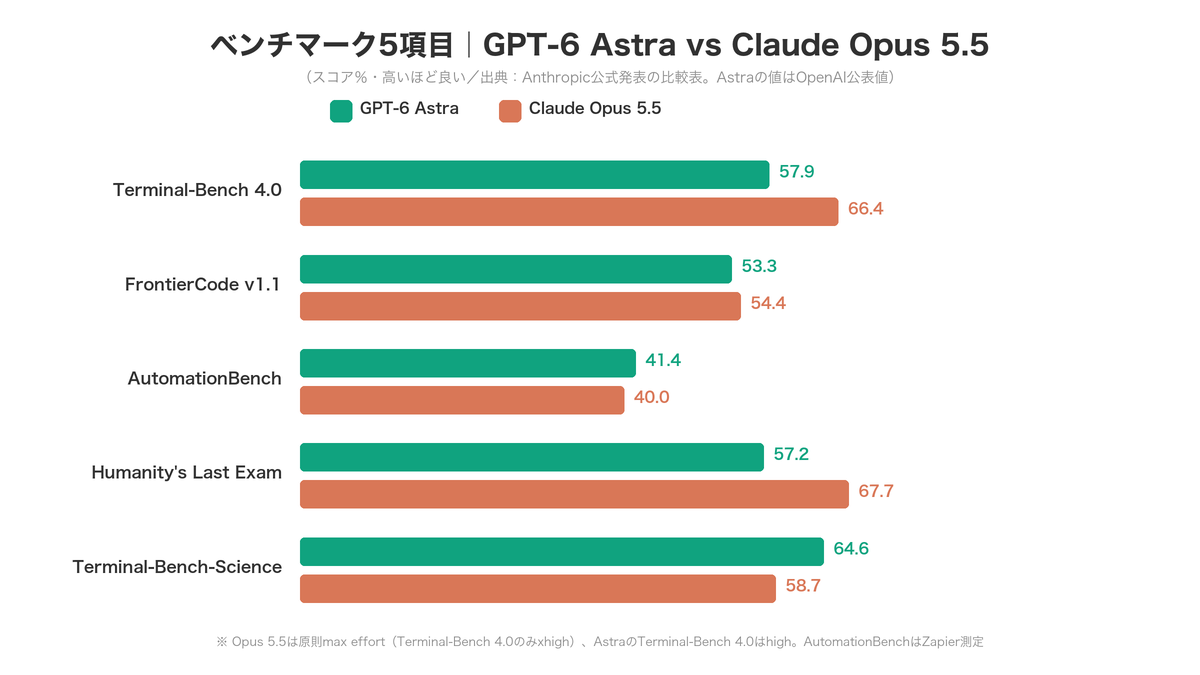
ここでは、AnthropicがOpus 5.5発表時に公開した比較表をもとに、GPT-6 AstraとOpus 5.5を並べます。Astraの値はOpenAIの公表値をAnthropicが転記したものです。
| ベンチマーク | GPT-6 Astra | Claude Opus 5.5 | 勝者 |
|---|---|---|---|
| Terminal-Bench 4.0(ターミナル操作) | 57.9% | 66.4% | Opus 5.5(+8.5pt) |
| FrontierCode v1.1(実務コードの品質) | 53.3% | 54.4% | Opus 5.5(+1.1pt) |
| GDPval-AA v2.1(知識労働・Elo) | 1,542 | 1,846 | Opus 5.5(+304) |
| AutomationBench(業務自動化) | 41.4% | 40.0% | Astra(+1.4pt) |
| Humanity's Last Exam(難問推論・ツールあり) | 57.2% | 67.7% | Opus 5.5(+10.5pt) |
| Terminal-Bench-Science(科学研究エージェント) | 64.6% | 58.7% | Astra(+5.9pt) |
| BrowseComp(Web調査) | 91.5% | 未公表 | Astra(参考) |
| AA Intelligence Index(独立評価の総合指数) | 53 | 58 | Opus 5.5(+5) |
※Astraの値はOpenAI公表値(BrowseCompはOpenAI発表の表より)。AA Intelligence IndexはArtificial Analysisの独立評価(2026年9月22日時点、いずれも最大の推論設定)。
独立評価機関Artificial Analysisの総合指数でも、Opus 5.5は58点で首位になりました。GPT-6 AstraとFable 5.1はどちらも53点で、差は5点です。同社はOpus 5.5について「エージェント型の知識労働でリードを広げた」と評価しています。
Opus 5.5が勝つ領域(コーディング・ターミナル・知識労働・難問推論)
Opus 5.5の勝ち筋は「成果物の品質」が問われる仕事です。知識労働を44職種の実務で測るGDPval-AA v2.1では1,846 Eloと、Astra(1,542)に300点以上の差をつけました。Anthropicは「既定の推論設定(medium)のOpus 5.5が、最大設定のAstraを約5分の1のコストで上回る」としています。資料の見栄えを含めて評価するArtificial AnalysisのAA-Briefcaseでも1,822 Eloで首位となり、同社は「Anthropicのモデルが見栄えの点でGPT-5.6 Solを初めて上回った」と書いています。
コーディングでも、ターミナル操作(Terminal-Bench 4.0)と実務コード(FrontierCode、CursorBench)でトップです。前回の比較でGPT-5.6 Solの牙城だったターミナル操作は、公式値ではOpus 5.5側に移りました。
GPT-6が勝つ領域(業務自動化・科学研究・Web調査・コスト効率)
Astraは、複数アプリをまたぐ業務フロー(AutomationBench 41.4%)、科学研究系のエージェント作業(Terminal-Bench-Science 64.6%)、Web調査(BrowseComp 91.5%)で上回っています。OpenAIはAstraを「PC操作で世界最高のモデル」とも位置づけています。
GPT-6側でもっとも差がつくのはコスト効率です。OpenAIの発表では、GPT-6 Solは業務自動化のAutomationBenchで33.2%(1タスクあたり$0.27)を記録し、Opus 5(最大設定・26.9%)をタスク単価の約9%で上回りました。Artificial Analysisも、SolとLunaは「性能はGPT-5.6と横ばいのまま、1タスクあたりのコストを約半分にした」と評価しています。
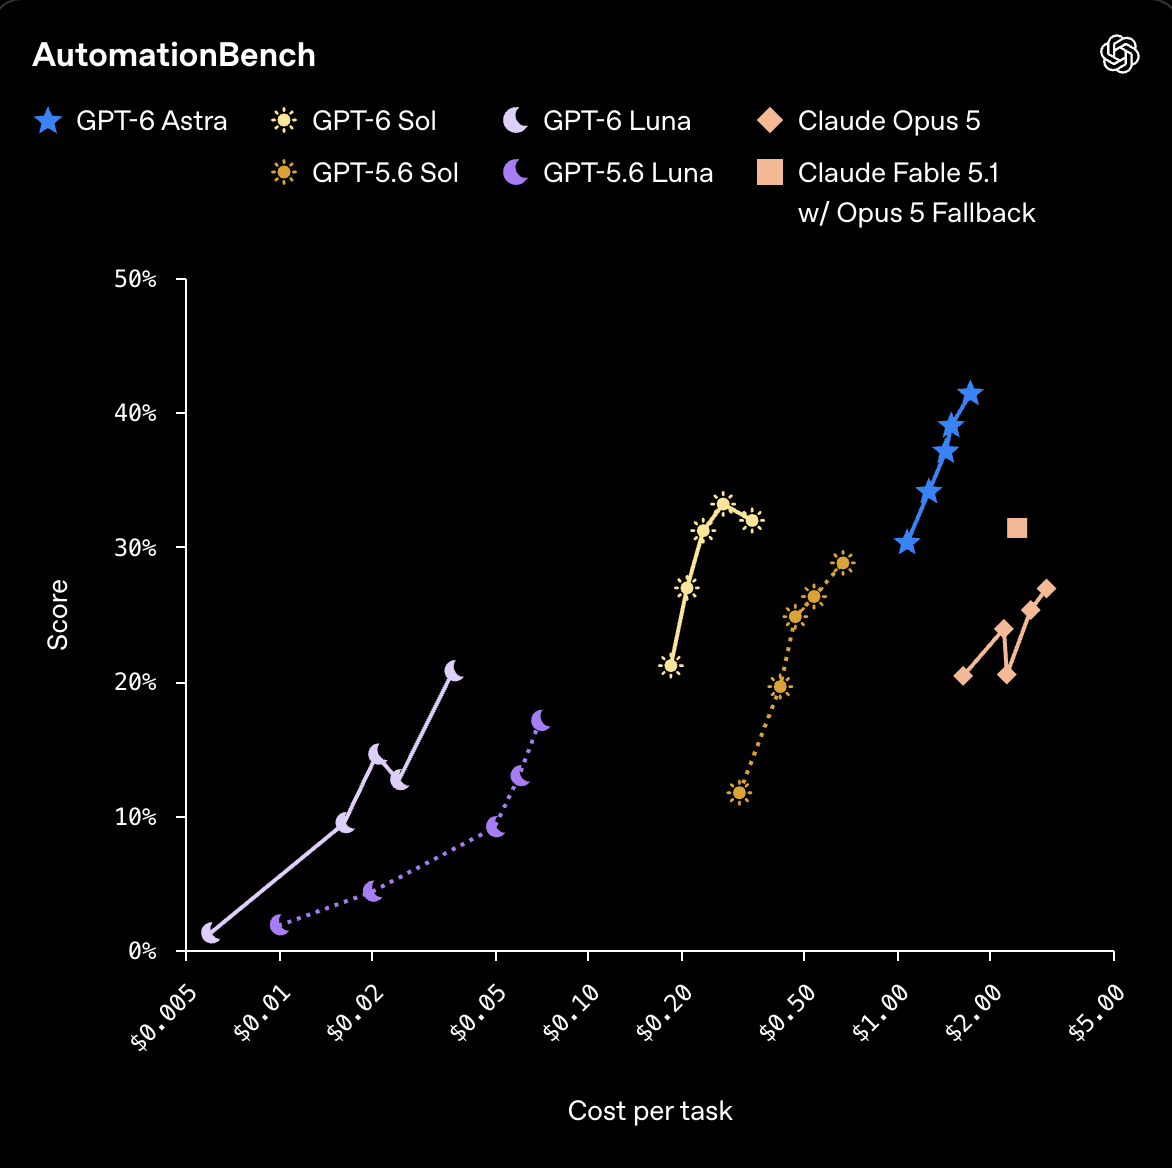
※OpenAIのSol/Luna発表はOpus 5.5と同日だったため、比較対象はOpus 5・Fable 5.1です。Opus 5.5とSolを同じ条件で比べた公式値はまだありません。
【重要】ベンチマークの数字をそのまま比べられない3つの理由
Anthropicも発表の中で「この能力水準では、ベンチマークの差は実利用の差の指標として信頼しにくくなっている」と述べています。ベンダー自身がそう書いている以上、点差だけで決めるのは危うい。本記事の使い分けは出発点にとどめ、自社の実タスクでA/Bテストして判断してください。
料金・速度・コンテキストの徹底比較
API利用時の実務比較項目を整理しました。以下の単価はすべてAPI従量課金($/100万トークン)の話です。ChatGPTやClaudeを月額サブスクで使う場合は定額制のため、トークン単価ではなく月額料金・利用上限・使えるモデルで比較してください。
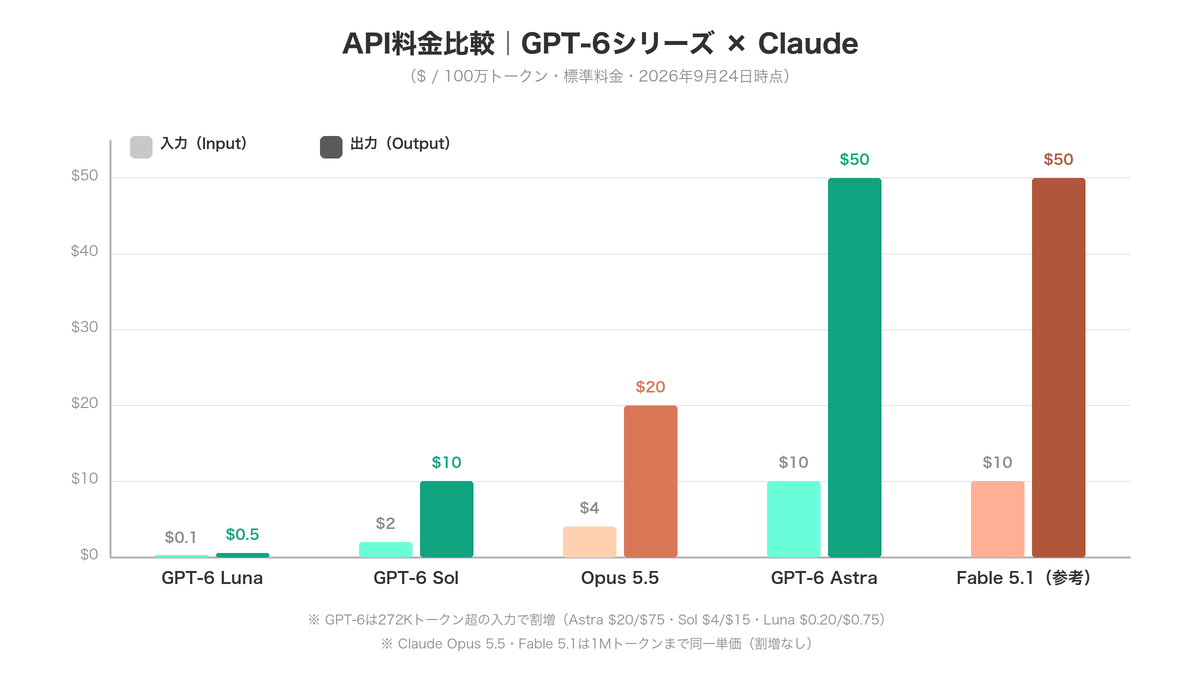
| 項目 | GPT-6シリーズ | Claude Opus 5.5 | 優位 |
|---|---|---|---|
| 入力(標準) | Astra $10/Sol $2/Luna $0.10 | $4 | Sol・LunaはOpus 5.5より安い |
| 出力(標準) | Astra $50/Sol $10/Luna $0.50 | $20 | 同上(AstraよりはOpus 5.5が安い) |
| 272K超の入力 | 割増あり(Astra $20/$75、Sol $4/$15) | 1Mまで割増なし | 予見性はOpus 5.5 |
| キャッシュ読み取り | Astra $1/Sol $0.20/Luna $0.01 | $0.20 | Solと同額、Lunaが最安 |
| バッチAPI | 50%割引(Astra $5/$25、Sol $1/$5) | 50%割引($2/$10) | 同等 |
| 高速モード | Fastモードは標準の2倍料金 | Fastモード $8/$40(最大2.5倍速) | 用途次第 |
| コンテキスト | 約105万トークン | 100万トークン | ほぼ同等 |
| 最大出力 | 128K | 128K | 同等 |
単価の構図|最上位同士ならOpus 5.5が6割安い
Astra($10/$50)とOpus 5.5($4/$20)を比べると、Opus 5.5は入出力とも60%安い計算です。前回の比較(Sol $5/$30 vs Opus 5 $5/$25)では差は出力の17%だけでしたが、今回は大きく開きました。一方、Sol($2/$10)はOpus 5.5の半額、Luna($0.10/$0.50)は40分の1です。「そこそこの性能で十分な業務」をSol・Lunaに回せるなら、GPT-6側のコスト削減余地はかなり大きいと言えます。
長文では「単価はSol、予見性はOpus 5.5」
GPT-6シリーズは、272Kトークンを超える入力に割増料金がかかります。Opus 5.5は1Mトークンまで同じ単価です(Anthropic公式料金)。ただし割増後のSol($4/$15)でも、Opus 5.5($4/$20)より出力が安い点は押さえておきましょう。契約書の束や大きなコードベースの一括処理では、単価はSol、料金の読みやすさと読解品質はOpus 5.5という構図です。
単価だけでなく「1タスクあたりの消費量」を見る
実際のコストは「単価 × 消費トークン数」で決まります。Artificial Analysisの計測では、Opus 5.5(最大設定)は1タスクあたり約11.9万トークンを出力し、Astra(最大設定)の約2.7万トークンの約4倍でした。Opus 5.5は単価が安くても、深く考えるぶんトークンを多く使うため、単価表だけでは実コストが読めません。effortを下げれば消費量は減らせるので、PoCで「タスク完了あたりの実コスト」と「待ち時間」を必ず実測してください。
業務活用10シーン別|GPT-6とOpus 5.5どっちを使うべきか
「結局うちの業務ではどっち?」に答えるため、デスクワークで頻出する10シーンに分けて推奨モデルを示します。
シーン1: コード修正・PR作成 → Opus 5.5
マージできる品質のコードかを測るFrontierCodeで54.4%(Astra 53.3%)、CursorBench 4.0で57.8%(GPT-5.6 Solは41.7%)と、Opus 5.5がトップです。Anthropicの発表では、68万行のコード移行を1日かからずに終えた早期テスターの事例も紹介されています。なお前回の比較で使ったSWE-Bench Proは、今回両社とも公表していません。
シーン2: ターミナル自動化・スクリプト作成 → Opus 5.5(コスト重視ならSol)
Terminal-Bench 4.0の公式値はOpus 5.5 66.4%、Astra 57.9%です。ただし第三者のArtificial Analysisの測定では両者とも59.6%前後で、差は公式値ほど大きくない可能性があります。デプロイ自動化・シェルスクリプト生成・CI/CD構築の第一候補はOpus 5.5ですが、大量に回すなら単価が半分のGPT-6 Solも検討候補です。
シーン3: Excel集計・データ分析・業務自動化 → 互角(量をこなすならSol)
Zapierが測定したAutomationBenchは、Astra 41.4%、Opus 5.5 40.0%でほぼ互角です。コストを重視するなら、33.2%を1タスク$0.27で出すGPT-6 Solが有力です。ただし40%前後という絶対値が示すとおり、複雑な業務自動化はどのモデルでも人の確認が前提です。
シーン4: 議事録・文書の要約 → 報告書作成 → Opus 5.5
前回はGPT-5.6 Solを推奨したシーンですが、今回は逆転しました。GDPval-AA v2.1でOpus 5.5は1,846 Elo、Astraは1,542 Eloです。Artificial Analysisは、GPT-6 SolとLunaはこの評価で前世代より点数を下げた(Solは約100 Elo低下)と報告しています。報告書・提案書のドラフトはOpus 5.5が第一候補です。
シーン5: パワポ(.pptx)・ドキュメント編集 → Opus 5.5
資料の見栄えまで評価するArtificial AnalysisのAA-Briefcaseで、Opus 5.5は1,822 Eloの首位となり、見栄えの項目でも他モデルを上回りました。グラフの読み取りを測るChartographyも89.0%です。社内プレゼンや提案書の自動生成はClaude側が向きます。
シーン6: 財務・会計分析 → Opus 5.5
Anthropicの発表では、架空の企業2社の合併案を分析し、Excelの財務モデルと経営層向けプレゼンを作るタスクで、Opus 5.5がOpus 5より速く(63分 vs 93分)、コストを50%抑えた例が紹介されています。アラインメント(AIが意図や許可された範囲に沿って振る舞うこと)の自動監査でも「これまでで最も良い成績」とされており、事実の取り違えが致命的な領域に向きます。ただし、最終的な数字は必ず人が確認してください。
シーン7: 画面操作・資料の読み取り(請求書・図面) → 用途で二分
画面を見てPCを操作するエージェント用途では、OpenAIがAstraを「PC操作で世界最高のモデル」としており、OSWorld 2.0(オフライン版)で72.6%を公表しています。Opus 5.5もOSWorld 2.0で81.8%を公表していますが、両社の測定セットが異なるため直接は比べられません。グラフや図表の読み取りはChartography 89.0%のOpus 5.5、画面操作の自動化はAstraをまず試すのが妥当です。
シーン8: Web調査・競合分析 → GPT-6 Astra
多数のページを巡回して答えを探すBrowseCompで、Astraは91.5%を記録しています。Opus 5.5はこの評価を公表していません。市場調査や競合リストの一次調査を任せる用途では、Astraが第一候補です。
シーン9: カスタマーサポート・社内Q&A自動応答 → GPT-6 Luna
入力$0.10/出力$0.50という単価で、FAQ参照型の即答用途はLunaが最有力です。OpenAIは、Lunaは推論を深くした設定でGPT-5.6 Solと同程度の事実性を約100分の1のコストで出すとしています。ただしArtificial Analysisの評価では、LunaはGDPvalなどの知識労働で前世代より点数を下げています。定型の即答はLuna、込み入った相談はSol以上に振り分けてください。
シーン10: 大量バッチ処理(API) → 短文はLuna、長文はSolかOpus 5.5
数千件の分類・要約・定型文生成のような1件あたりが短い大量処理は、Lunaが圧倒的に安価です。272Kトークンを超える長文のバッチは、単価だけならSol(割増後$4/$15)、料金の読みやすさと読解品質を重視するならOpus 5.5(1Mまで一律、バッチ$2/$10)が向きます。サブスクリプションの範囲で手作業処理できる量なら、この単価比較は当てはまりません。
中堅企業のための「併用戦略」3パターン
今回の結果を見る限り、どちらか1社に寄せると、どこかの業務で割高か力不足になります。中堅企業のDX担当者が採用しやすい併用の形を3つ紹介します。
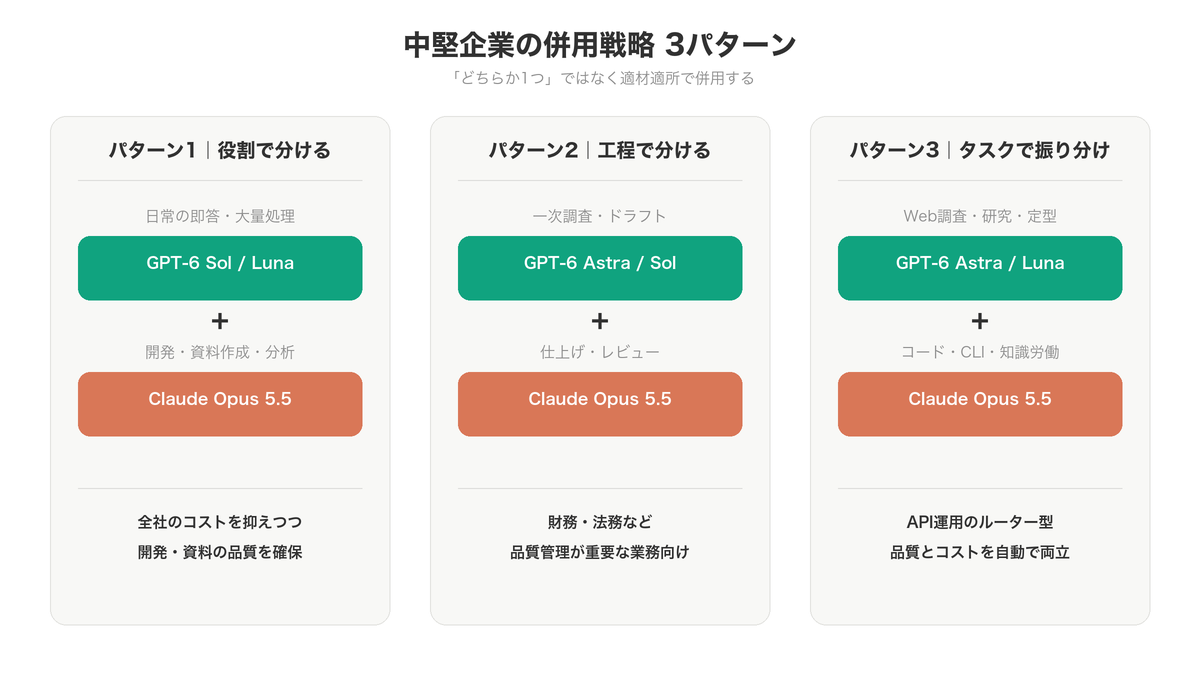
パターン1: 日常の即答・大量処理はGPT-6 Sol/Luna、開発・資料作成はOpus 5.5
問い合わせ対応や定型の要約など件数の多い業務はSol・Lunaの低単価でまかない、開発部門や資料作成・分析の中核にはClaude(Opus 5.5)を使います。全社コストを抑えながら、品質が問われる業務の性能を確保できる構成です。
パターン2: 一次調査・ドラフトはGPT-6 Astra/Sol、仕上げとレビューはOpus 5.5
Web調査や一次ドラフトをGPT-6側で進め、最終的な文書化・レビューをGDPval-AAで大きくリードするOpus 5.5で行う二段構えです。「集めるのはGPT、仕上げるのはClaude」という工程分離は、財務・法務など品質管理が重要な業務で特に有効です。
パターン3: タスク特性で振り分け(Web調査・研究はAstra、定型はLuna、コード・知識労働はOpus 5.5)
API利用を前提に、Web調査・科学研究系はAstraへ、短文の大量処理はLunaへ、コード修正・ターミナル操作・報告書作成はOpus 5.5へ自動で振り分けるルーター型です。各タスクを得意なモデルに割り当て、品質とコストを両立できます。
導入・移行時の注意点
Opus 5 → Opus 5.5の移行は「値下げドロップイン」だが4点を確認
Opus 5.5はOpus 5より安く、モデルIDをclaude-opus-5-5に変えれば基本的に移行できます。ただしAPIでは次の点が変わります。①思考を無効化できなくなったため、無効化の設定を残すとエラーになります。②effortの既定値がhighからmediumに下がったため、品質を保ちたい処理は明示的に指定してください。③ツール呼び出しを強制する設定(tool_choiceのany/tool)がエラーになります。④PC操作ツールの指定方法が変わります(Claude APIとGoogle Cloudでは新しいcomputer_toolset_20260801のみ)。Opus 5はAPIで引き続き利用できるため、段階的に移行できます。
GPT-5.6 → GPT-6の移行はTerraの行き先から
GPT-6世代にはTerraがありません。GPT-5.6 Terra($2/$12)を使っていた処理は、同じ入力単価で出力が安いGPT-6 Sol($2/$10)が移行先の候補になります。GPT-5.6は引き続き提供されており、OpenAIの料金ページでは「GPT-5.6 Solのキャンペーン価格は少なくとも2026年11月21日まで」とされています。ChatGPTの通常のChat画面ではSol・Lunaがまだ使えない点にも注意が必要です。
ベンチマークを鵜呑みにせず、自社タスクで実測する
測定条件・安全装置・実行環境の違いで数値が動くうえ、両社とも自社に有利なベンチマークを選んで公表しています。導入判断は「公表スコアで一次絞り込み → 自社の代表タスク10〜20件でA/Bテスト → 品質・コスト・速度を実測」の3段階をおすすめします。
セキュリティ・コンプライアンスの確認ポイント
OpenAIはGPT-6 Astraのシステムカードで、同社の安全性評価の枠組みにおいてサイバーセキュリティ能力を初めて最上位の「Critical」と判定し、評価中であることに気づく割合の上昇や、思考過程を監視しにくくなった点も開示しています。Anthropicは、Opus 5.5で生物学分野の安全分類器を追加し、安全装置が応答を止めた場合に別モデルへ切り替える仕組みも用意しています。金融・医療・公共セクターでの導入時は、各社のSOC 2・ISO 27001ステータスと、データ保持・学習不使用の契約条件を確認してください。
まとめ|2026年秋の「主軸AI」をどう選ぶか
9月22日の同日発表で、力関係は再び動きました。コーディング・ターミナル操作・報告書などの知識労働・資料作成ではOpus 5.5がリードし、Web調査・科学研究系ではGPT-6 Astra、低単価の大量処理ではGPT-6 Sol・Lunaが優位です。料金は「最上位同士ならOpus 5.5が大幅に安く、中位・下位ならGPT-6が安い」という構図になりました。
中堅企業のDX担当者にとっての実務的な答えは次の3点です。
- 最初に業務を棚卸しする。社内のAI活用業務を「調査・研究型」「コード・資料作成型」「大量定型処理型」に分類する
- ベンチマークではなく実タスクで検証する。公表スコアは測定条件がそろっていないため一次絞り込みまで。代表タスクのA/Bテストで決める
- 併用を前提に設計する。単一モデル依存はロックインのリスクがある。パターン1〜3のいずれかで併用環境を作る
この記事自体、2026年4月の初版から、新モデルが出るたびに書き直してきました。それだけモデルの入れ替わりは速く、そのたびに全社で乗り換えていたら現場がもちません。個人的には、どのモデルが勝つかを当てるより、モデルを差し替えられる業務設計にしておくほうが、ずっと効くと考えています。モデルの選定から業務への組み込み、社内ルールの整備までを外部と一緒に進めたい場合は、ZIDAIのAI推進室でも、ツール選定から業務設計、定着までを伴走型で支援しています。
よくある質問(FAQ)
Q1. Claude Opus 5.5はOpus 5から何が変わった?
料金が$5/$25から$4/$20に20%下がり、キャッシュ読み取りは60%安くなりました。公式は、1タスクあたりの消費トークン減も含めて「典型的な業務で40%のコスト減」と説明しています。性能面では、Terminal-Bench 4.0が52.3%→66.4%、GDPval-AA v2.1が1,708→1,846 Eloと向上しました。仕様面では、思考が常にオンになり、effortの既定値がmediumに変わっています。
Q2. GPT-6のAstra/Sol/Lunaはどう使い分ける?
最も難しい仕事や最高の結果が欲しいときはAstra($10/$50)、コーディングやエージェント作業を安く回したいときはSol($2/$10)、分類・要約・定型応答などの大量処理はLuna($0.10/$0.50)です。OpenAIは、Solが業務自動化のAutomationBenchで低い推論設定のAstraを上回ったと公表しており、多くの業務はSolから試すのが現実的です。
Q3. 資料によってベンチマーク数値が違うのはなぜ?
測定条件(推論設定・実行環境・試行回数・安全装置の扱い)が違うためです。たとえばOpus 5.5のTerminal-Bench 4.0は、Anthropic公表値が66.4%、Artificial Analysisの測定が59.6%です。Opus 5のTerminal-Bench 4.0も、OpenAIの表では52.6%、Anthropicの表では52.3%と、転記元によって小さく食い違います。数値を見るときは「誰が・どの版で・どの条件で測ったか」をセットで確認してください。
Q4. ChatGPTでGPT-6は使える?どのプランが必要?
2026年9月24日時点で、GPT-6 SolとLunaはChatGPT WorkとCodexでPlus・Pro・Business・Enterprise・Eduに提供され、FreeとGoはデスクトップアプリでLunaを使えます。通常のChat画面ではまだ使えません。Astraは、OpenAIヘルプセンターの記載では、Chat画面では「GPT-6 Pro」としてPro・Business・Enterpriseが対象です。展開状況は変わりやすいため、自社アカウントで確認してください。
Q5. ClaudeでOpus 5.5を使うにはどのプランが必要?
Claudeの有料プラン(Pro・Max・Team・Enterprise)で利用できます。Opus 5.5の発表にあわせて、Pro・Max・Team・シート制Enterpriseの5時間あたりの利用上限が引き上げられました。Claude Codeでは既定のOpusモデルがOpus 5.5になっています。無料プランでは利用できません。
Q6. 日本語処理ではどちらが優れている?
両社とも、日本語に特化したベンチマークの差を公式には開示していないため断定はできません。日本語中心の業務では、両モデルを同じプロンプトでA/Bテストし、品質とコストを比べることをおすすめします。報告書や議事録の要約では、GDPval-AAで大きくリードするOpus 5.5をまず試す価値があります。
Q7. 社内データを扱う際、どちらが安全?
両社とも法人向け契約で「入力データを学習に使わない」ことを定めています。認証(SOC 2 Type II、ISO 27001など)も両社が取得を公表していますが、更新制のため導入時点で最新ステータスを確認してください。セキュリティの差よりも、自社の既存クラウド(AWS・Google Cloud・Azure)との統合しやすさで判断するのが実務的です。
Q8. Claude Fable 5.1とはどう違う?どれを選ぶべき?
Fable 5.1はAnthropicの最上位モデル($10/$50)です。ただしOpus 5.5は、Anthropicの公式表でTerminal-Bench 4.0・GDPval-AA・Humanity's Last Examなど多くの項目でFable 5.1を上回り、料金は5分の2です。Anthropic自身が「迷ったらOpus 5.5から」と案内しており、実務の主役はOpus 5.5、最高難度の推論だけFable 5.1という整理が現実的です。
Q9. コーディングはGPT-6とOpus 5.5どっち?
既存コードの修正・PR作成・ターミナル操作はOpus 5.5がリードしています(FrontierCode 54.4%、Terminal-Bench 4.0 66.4%)。一方で、長期のソフトウェア開発課題を測るDeepSWEでは、OpenAIがAstraの74.1%を公表しています(Opus 5.5の値は未公表)。コストを抑えて大量に回すなら、GPT-6 Solも有力な選択肢です。
Q10. いまGPT-5.6やOpus 5を使っている場合、乗り換えるべき?
基本的にはYesです。GPT-6 SolはGPT-5.6 Solの半額で、Opus 5.5はOpus 5より安く性能も上がっています。ただしOpus 5.5では思考の無効化・ツール呼び出しの強制ができなくなり、effortの既定値も変わるため、APIで使っている場合は設定を確認してください。GPT-5.6・Opus 5とも当面は併売されるため、重要な業務はA/B検証してから段階的に移行すると安全です。
Q11. 今後、比較の構図はまた変わる?
変わる可能性が高いです。AnthropicはSonnet 5.5とHaiku 5.5を「今後数週間で」投入予定としており、下位モデル同士の比較(Sonnet 5.5 vs GPT-6 Solなど)が次の焦点になります。OpenAIもGPT-6 Sol・LunaのChat画面への提供を控えています。本記事も、新モデルの登場にあわせて更新していきます。