Claude FableとOpusの使い分けは、「普段の作業はOpus 5.5、数時間かかる自律作業や原因の分からない難問だけFable 5.1」が基本です。Anthropicの公式ドキュメントも「どのモデルを使うか迷ったら、まずClaude Opus 5.5から始める」と案内しています。
2026年9月22日に登場したClaude Opus 5.5は、公式ベンチマークで最上位モデルのClaude Fable 5.1をすべての項目で上回り、API料金はFable 5.1の5分の2です。とはいえ、Fable 5.1が不要になったわけではありません。長時間の作業を任せたときの粘り強さや、自分で調べて検証する丁寧さには、Fable 5.1ならではの強みがあります。
「モデル選択欄にFableとOpusが並んでいて、結局どっちを選べばいいのか分からない」。そんな方に向けて、本記事では2026年9月24日時点の公式情報をもとに、両モデルの強み・弱み、作業ごとの使い分け、ProとMaxでの料金と利用上限の違いを整理します。
目次
【結論】普段はOpus 5.5、長丁場と難問だけFable 5.1
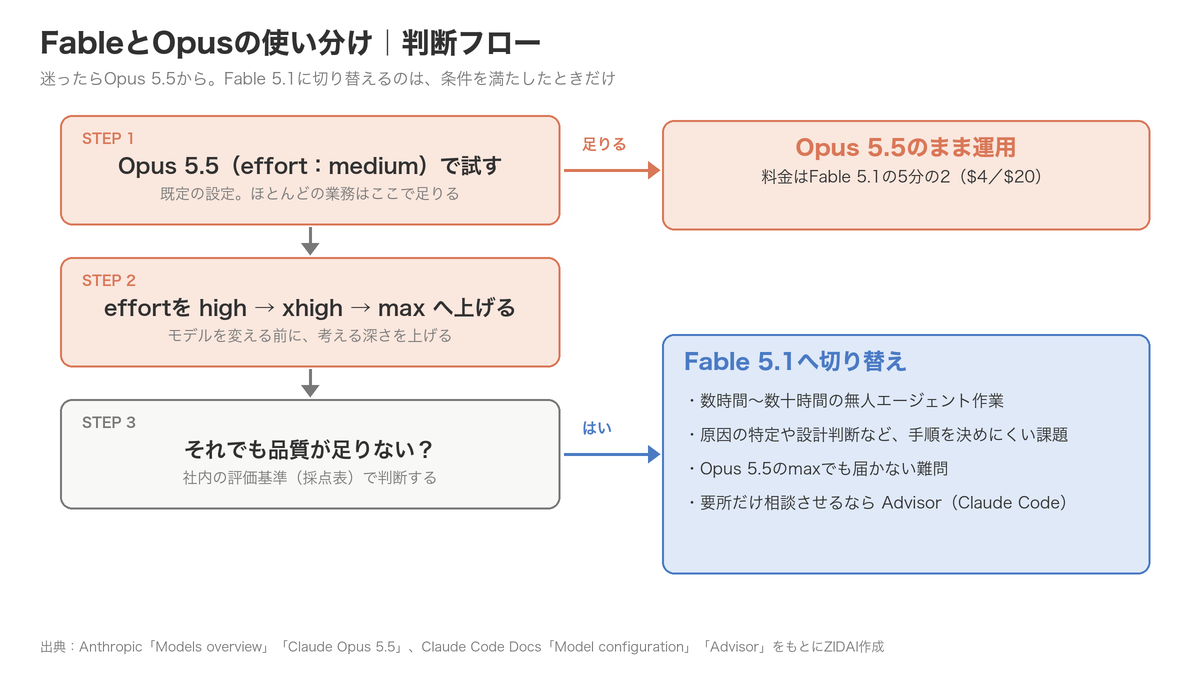
迷ったときの判断は、次の3つで足ります。
- まずはOpus 5.5で始めます。文章作成・調べもの・資料作成・コード修正など、日常の作業のほとんどはこれで足ります
- 物足りないと感じたら、モデルを変える前にeffortを上げてみてください。effort(エフォート)とは、Claudeが1回の回答でどれだけ深く考えるかを決める設定で、low・medium・high・xhigh・maxの5段階があります
- Fable 5.1は「ここぞ」という場面用です。数時間以上かけて任せたい作業や、原因の特定・設計判断のように手順を決めにくい課題が出番です
公式の案内も「迷ったらOpus 5.5」
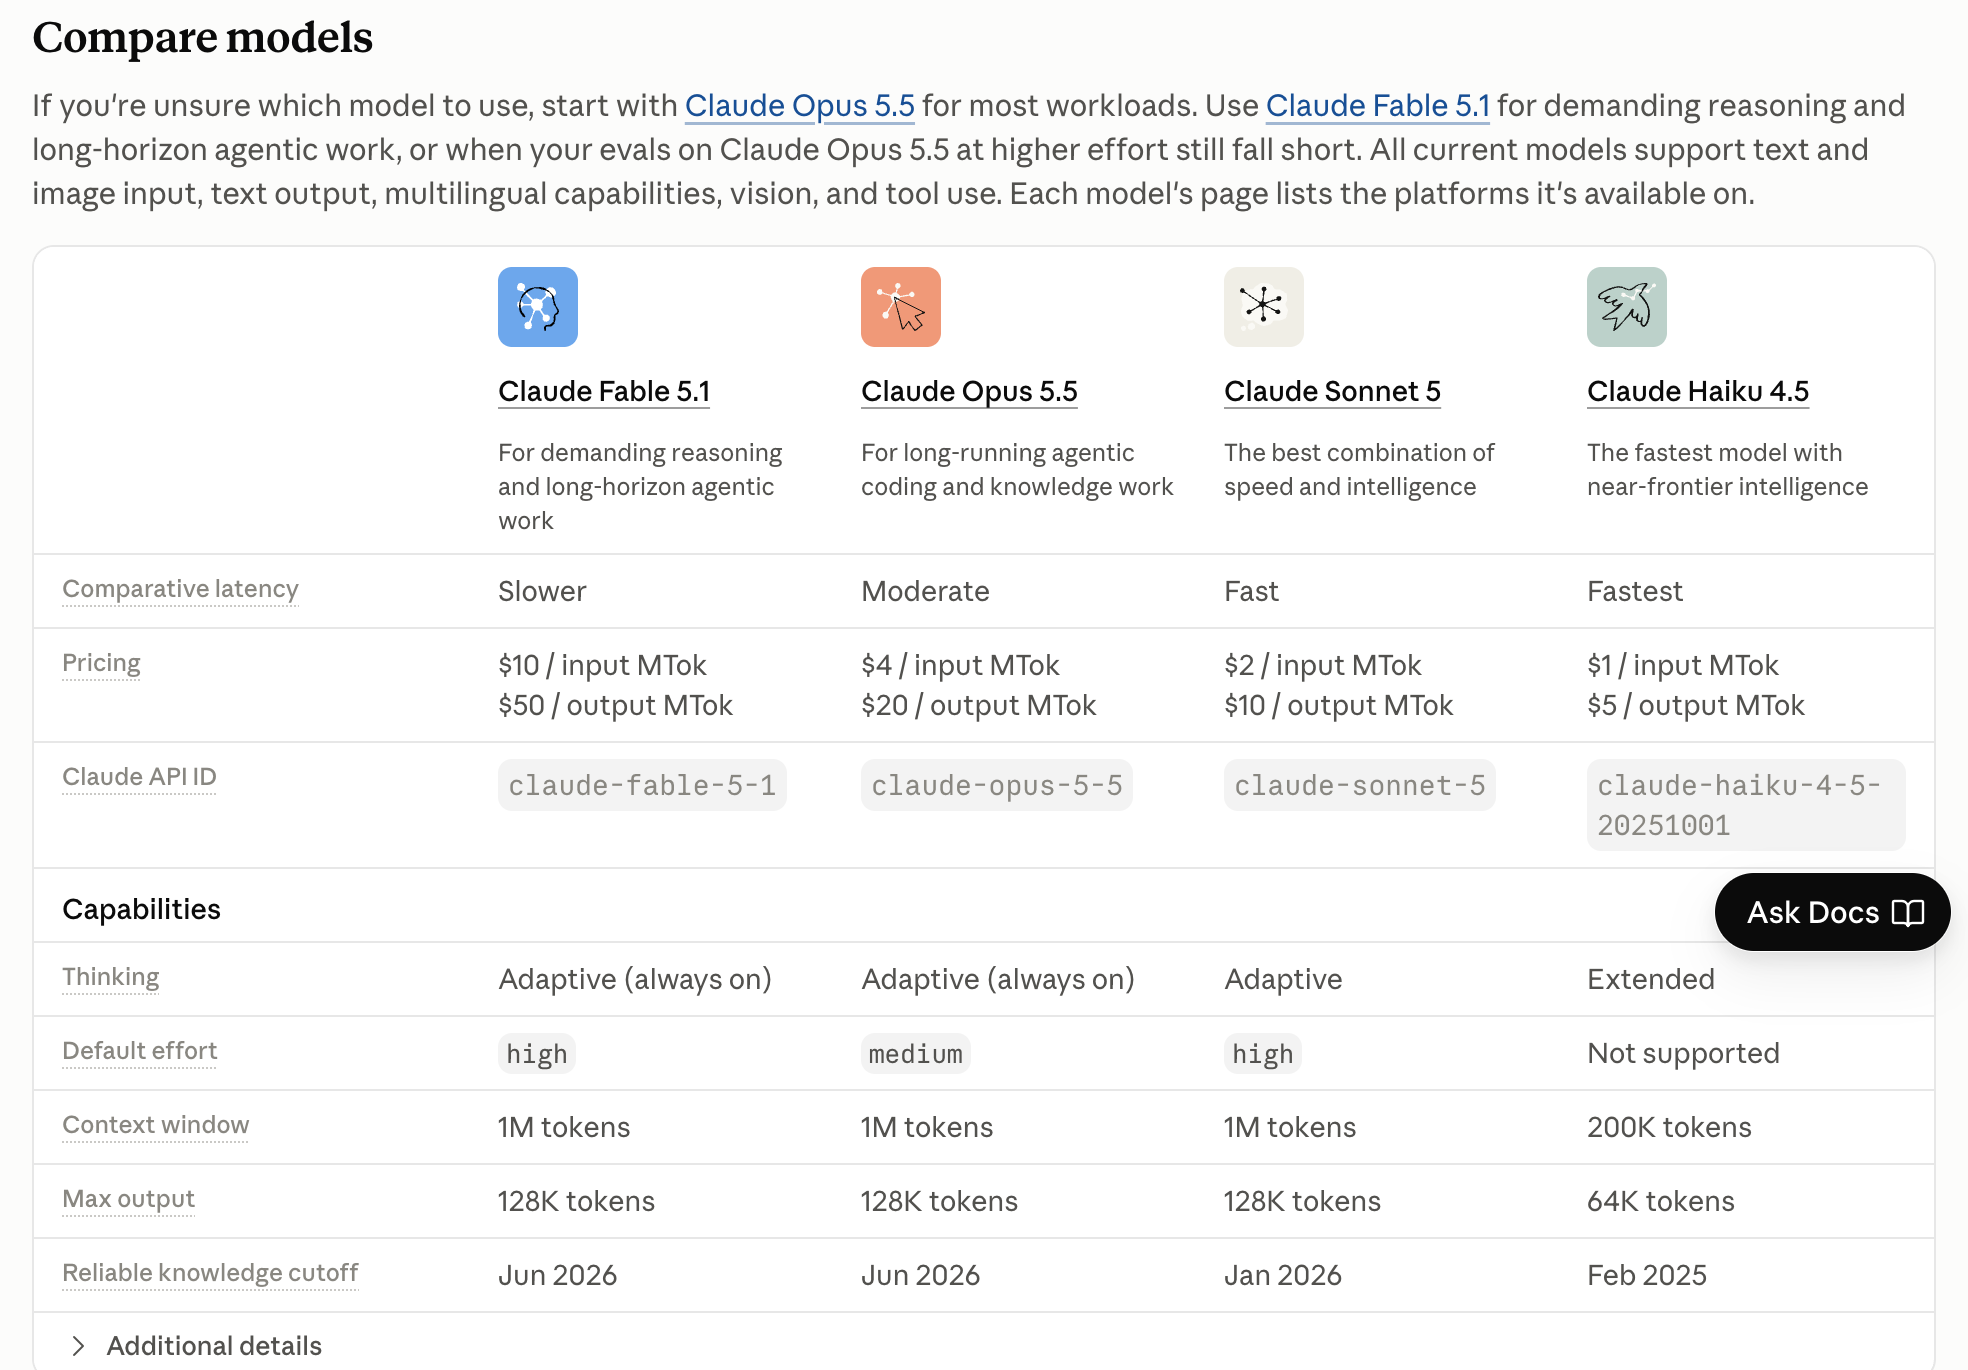
Anthropicの開発者向けドキュメント「Models overview」は、使い分けを次のように説明しています。
- 迷ったら、ほとんどの作業はClaude Opus 5.5から始める
- Claude Fable 5.1は、高難度の推論と長期のエージェント作業に使う
- または、Opus 5.5のeffortを上げても結果が基準に届かないときに使う
Opus 5.5の発表でもAnthropicは、「社内で使う限り、Opus 5.5とFable 5.1の差はスコアが示すほど大きくない」と述べています。「最上位だからFable」と考えるより、Opus 5.5で足りない理由がはっきりしたときにFableへ切り替えるほうが、上限も費用も無駄にしません。
Claude Fable 5.1とOpus 5.5は何が違う?【比較表】
Fable 5.1とOpus 5.5は、どちらもAnthropicの2026年秋時点の主力モデルです。位置づけ・料金・速度・既定の推論設定が異なります。Fable 5.1で何が変わったかはClaude Fable 5.1の解説記事、GPT-6シリーズとの比較はGPT-6とOpus 5.5の比較記事で扱っています。
| 項目 | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| 発表日 | 2026年9月22日 | 2026年9月1日 |
| 公式の位置づけ | 長時間のエージェント型コーディングと知識労働向け | 高難度の推論と長期のエージェント作業向け |
| 相対的な応答速度 | Moderate(中程度) | Slower(遅め) |
| 既定のeffort | medium | claude.ai・Coworkはmedium、Claude Code・APIはhigh |
| Proプラン | 利用上限の範囲で使える | 利用上限に含まれず、usage credits(従量課金)で使う |
| Maxプラン(5x/20x) | 利用上限の範囲で使える | 週次上限の50%まで追加費用なし |
| API料金(入力/出力、100万トークンあたり) | $4/$20 | $10/$50 |
| Fastモード(高速出力・API) | あり($8/$40、research preview) | なし |
| コンテキスト長/最大出力 | 100万トークン/12.8万トークン | 100万トークン/12.8万トークン |
出典:Anthropic「Models overview」「Pricing」「Claude Fable 5.1 and Mythos 5.1」、claude.com/pricing(2026年9月24日確認)
性能:公式表でFable 5.1が上回る項目はない
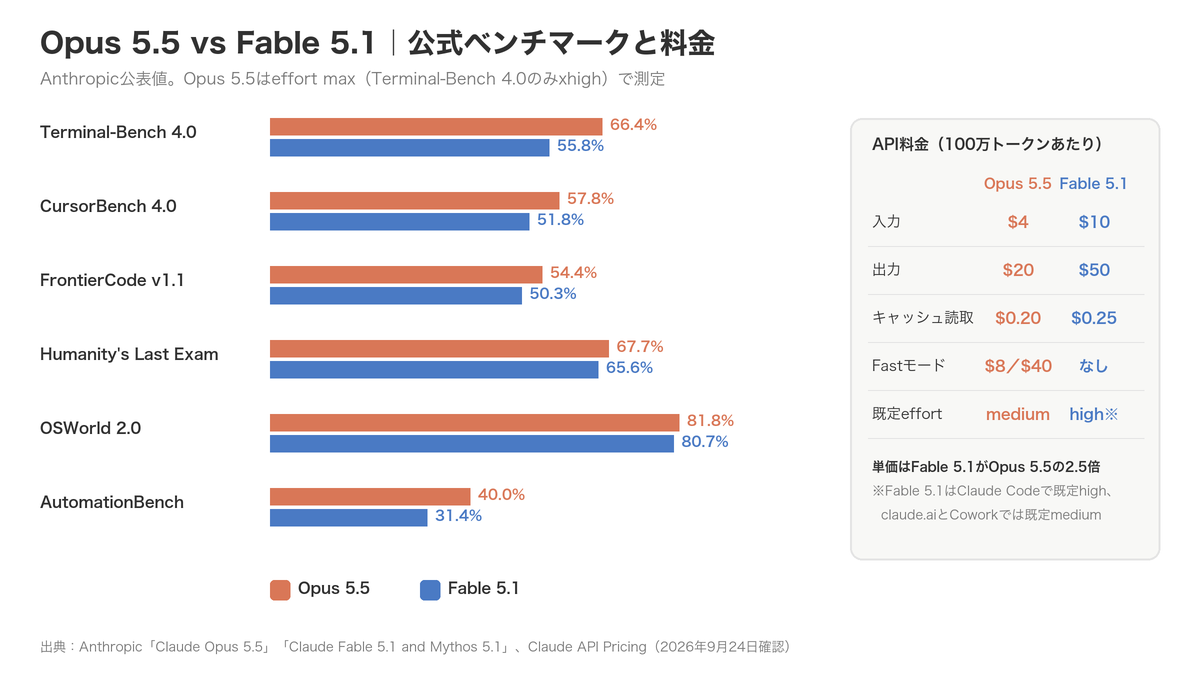
Opus 5.5の発表ページに掲載された比較表では、コーディング・知識労働・PC操作・業務自動化のどの項目でも、Opus 5.5がFable 5.1を上回っています。差が大きいのは、ターミナル操作のTerminal-Bench 4.0(66.4%対55.8%)と、業務自動化のAutomationBench(40.0%対31.4%)です。
数字を読むときは、次の3点を頭に置いておいてください。
- Opus 5.5は最大設定(max、Terminal-Bench 4.0のみxhigh)で測った値です
- 独立評価機関Artificial Analysisの総合指数(Intelligence Index v4.3.2)でも、Opus 5.5(max)は58点で首位、Fable 5.1は53点でした
- Anthropic自身が「この能力水準では、ベンチマークの差は実利用の差の目安として信頼性が下がっている」と注記しています
性能を理由にFable 5.1を選ぶ根拠は、ベンチマークからは出てきません。Fable 5.1を選ぶ理由は、次の章で見る「長時間の作業での粘り強さ」に置くのが自然です。
料金とトークン消費:単価は2.5倍、消費量はOpusが多め
API単価は、入力・出力ともにFable 5.1がOpus 5.5の2.5倍です。とはいえ実際の費用は「単価×消費トークン数」で決まります。
Artificial Analysisの計測では、総合指数の1タスクあたりの出力トークン数は、最大設定でOpus 5.5が約11.9万、Fable 5.1が約7.8万でした。Opus 5.5は深く考えるぶん、トークンを約1.5倍使います。それでも単価の差が大きいため、この条件で出力の費用を概算すると、Opus 5.5のほうが約4割安くなります(試算:11.9万×$20=約$2.4、7.8万×$50=約$3.9)。
Opus 5.5とFable 5.1、それぞれの強み・弱みは?
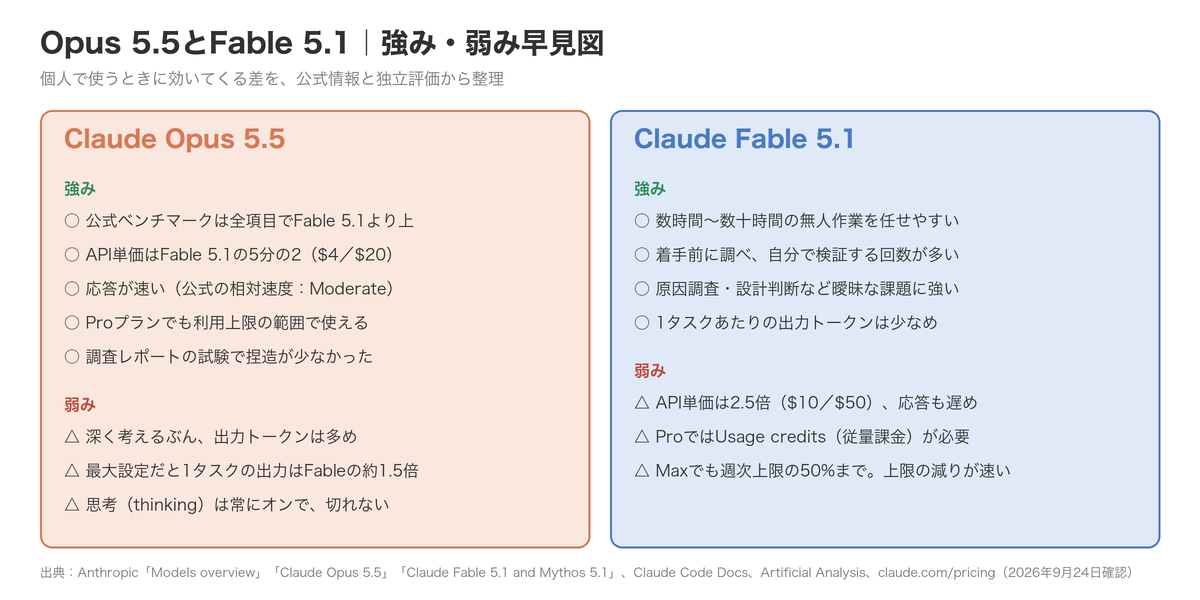
Opus 5.5の強み:速い・安い・ほとんどの作業で上
- 公式ベンチマークは全項目でFable 5.1より上です。知識労働を44職種の実務で測るGDPval-AA v2.1では、Opus 5.5が1,846 Elo、Fable 5.1が1,735 Eloでした
- 応答が速いのも利点です。公式の相対速度はOpus 5.5が「Moderate」、Fable 5.1が「Slower」です。Opus 5.5はOpus 5と比べても出力が30%以上速くなりました
- 調べものが正確です。決算資料が見つけにくいWebから四半期レポートを書かせるAnthropicの社内試験では、捏造した数字や引用が1つでもあれば不合格という基準で、Opus 5.5は18本中16本が合格しました。Fable 5.1は1本も合格していません
- Proプランでも、利用上限の範囲で気軽に使えます。発表にあわせてProとMaxの5時間あたりの利用上限も引き上げられました
Opus 5.5の弱み:深く考えるぶんトークンを多く使う
- 最大設定では、1タスクあたりの出力トークンがFable 5.1の約1.5倍です(Artificial Analysis)。effortをmaxにしたまま使い続けると、そのぶん利用上限の減りも速くなります
- 思考(thinking)は常にオンで、切ることはできません。深さはeffortで調整します
- 資料作成を評価するArtificial AnalysisのAA-Briefcaseでは総合首位ですが、採点基準(ルーブリック)に沿った評価の項目だけは、Fable 5.1がわずかに上でした
Fable 5.1の強み:長時間の作業と自己検証
- 数時間〜数十時間の無人作業に向いています。Claude Codeの公式ドキュメントは、Fableを「1回の作業時間に収まらない大きさのタスク」に向くモデルと説明しています。Fable 5.1の発表では、早期テスターが38時間の無人実行で機械学習の問題を診断した事例も紹介されています
- 調べてから動き、自分で検証します。公式ドキュメントによると、Fableは行動の前に調査し、小さいモデルより頻繁に自分の作業を検証します。「テストして」「確認して」といった念押しは、たいてい不要です
- 原因の特定が得意です。早期テスターの評価では、Claude Codeで試したビルド失敗のすべてで、どのeffortでも根本原因を正しく特定しました
- 1タスクあたりの出力トークンは少なめで、最大設定での出力はOpus 5.5の約3分の2です
Fable 5.1の弱み:費用・速度・利用上限
- API単価はOpus 5.5の2.5倍で、応答も遅めです。高速出力のFastモードもありません
- Proプランでは利用上限に含まれず、最初の1回からusage creditsによる従量課金になります
- Maxプランでも使えるのは週次上限の50%までで、他のモデルより上限を速く消費します
- 公式ベンチマークでは、どの項目もOpus 5.5を下回っています
作業別の使い分け8選
作業ごとのおすすめを表にまとめました。effortは目安です。
| 作業 | おすすめ | 目安のeffort | 理由 |
|---|---|---|---|
| 1. 日常の質問・アイデア出し | Opus 5.5 | low〜medium | 応答が速く、上限の減りも少ない |
| 2. メール・企画書・ブログの下書き | Opus 5.5 | medium | 知識労働の評価GDPval-AAでFable 5.1を上回る |
| 3. Web調査・レポート作成 | Opus 5.5 | high | 捏造ゼロの基準を18本中16本でクリア(Fable 5.1は0本) |
| 4. スライド・資料づくり | Opus 5.5 | medium〜high | 見栄えも評価するAA-Briefcaseで首位 |
| 5. 日常のコード修正・レビュー | Opus 5.5 | medium〜high | FrontierCode・CursorBenchでFable 5.1を上回る |
| 6. 大規模なコード移行・リファクタリング | Opus 5.5(届かなければFable 5.1) | xhigh | C言語からRustへの移植で、Fable 5.1より2.5時間早く完了 |
| 7. 寝ている間に回す長時間の自律作業 | Fable 5.1 | high | 38時間の無人実行事例。長く動かしても方針を見失いにくい |
| 8. 原因不明のバグ調査・設計の相談 | Fable 5.1 | high | 調査と自己検証が深く、曖昧な問題に向く |
1〜4. 文章・調査・資料づくりはOpus 5.5
メールや企画書の下書き、Webでの調べもの、スライド作成といった作業は、Opus 5.5で十分です。速く返ってくるので、何度も直しを入れながら進める使い方とも相性が良いです。
調べものでは、Opus 5.5の正確さが目立ちます。捏造のないレポートを18本中16本書けたOpus 5.5に対し、Fable 5.1は0本でした。数字や引用の正確さが大事な調査ほど、Opus 5.5を選ぶ理由があります。
5〜6. コーディングもまずOpus 5.5
日常のコード修正はもちろん、大規模な作業でもOpus 5.5が先です。AnthropicがHAProxy(Webの負荷分散ソフト)をC言語からRustに移植させた試験では、両モデルとも回帰テストをほぼすべて通しました。そのうえで、Opus 5.5は9.5時間、Fable 5.1は12時間で完了し、Opus 5.5のコストは51%少なく済んでいます。20万行のコード監査を3時間未満で終えた早期テスターの事例(Opus 5は20時間超)もあります。
7. 長時間の自律作業はFable 5.1
Fable 5.1の出番は、人が見ていない間に何時間も走らせる作業です。早期テスターは38時間の無人実行で、機械学習の過去の結果がデータのラベルの不備による見かけ上のものだと突き止めて修正し、夜のうちに6つの実験を並行して回して、結果と次の手を持ち帰らせています。別のテスターも「長く多段階の作業でも、経過が追いやすい」と評価しています。
ただ、Opus 5.5も長時間の作業は苦手ではありません。まずOpus 5.5で走らせ、途中で方針を見失う、検証が甘いといった問題が出たらFable 5.1という順番が無難です。
8. 原因不明の不具合や設計の相談はFable 5.1
Claude Codeの公式ドキュメントは、Fableを使いこなすコツとして次の点を挙げています。
- 手順ではなく、欲しい成果を伝える
- 原因調査・障害対応・アーキテクチャの判断など、曖昧な問題を渡す
- 普段なら分割して渡す大きさの仕事を、まとめて渡す
「どこから手をつければいいか分からない」タイプの問題ほど、Fable 5.1の調査と検証の深さが生きます。
ProとMaxではどう違う?個人プランでの使い方と注意点
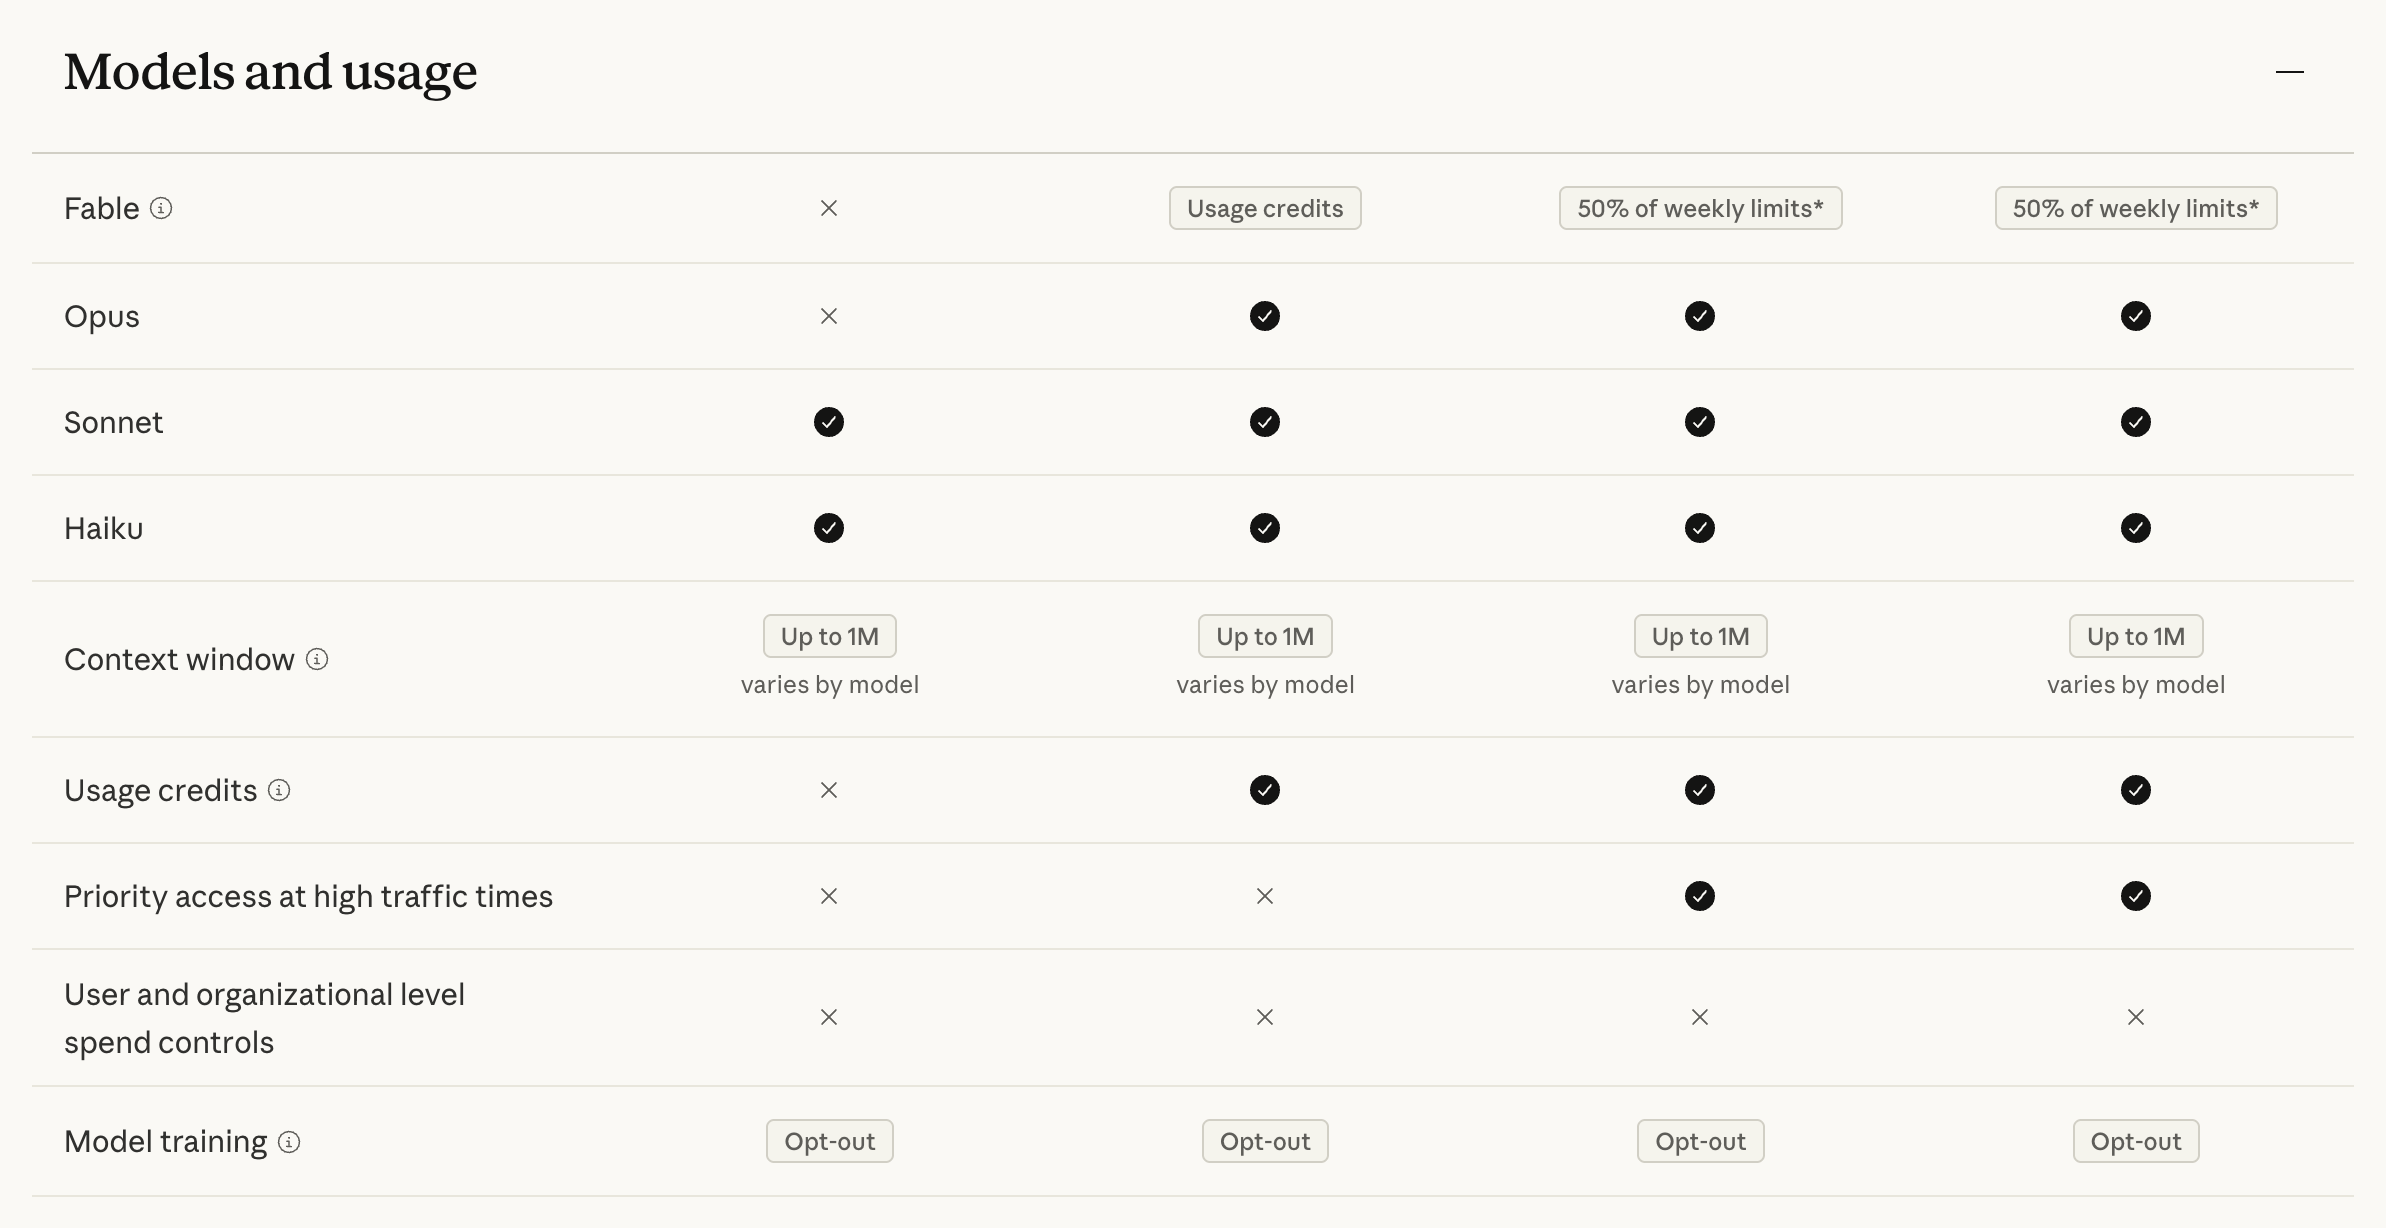
個人向けプランでのFableとOpusの扱いは、claude.comの料金ページとClaudeヘルプセンター「Claude Fable models on your plan」で次のように案内されています。
| プラン | Fable 5.1 | Opus 5.5 |
|---|---|---|
| Free | 使えない | 使えない |
| Pro | usage creditsで従量課金(プランの利用上限の外) | 利用上限の範囲で使える |
| Max 5x/Max 20x | 週次上限の50%まで追加費用なし。超えたらusage creditsか別モデルへ | 利用上限の範囲で使える |
usage credits(ユーセージクレジット)とは、プランに含まれる利用量を超えて使った分を、API標準単価で支払う従量課金の仕組みです。
Proでは、Fableを選んだ時点で従量課金
Proプランでは、Fable 5.1はプランの利用上限に含まれません。最初の1回からusage creditsでの従量課金になり、入力100万トークンあたり$10、出力100万トークンあたり$50がかかります。Proで使うのは、Opus 5.5では届かなかった作業に限るのが現実的です。
Maxの「50%」は上乗せ枠ではない
Maxプランでは、週次上限の50%までFableを追加費用なしで使えます。勘違いされやすいのですが、この50%はFable用に追加される枠ではなく、プラン全体の週次上限の一部です。Fableは他のモデルより速く上限を消費するため、週の前半にFableを使いすぎると、Opus 5.5で作業できる残りも減ります。日常の作業はOpus 5.5、ここぞという作業だけFable 5.1、と分けたほうが1週間を通して作業を止めずに済みます。
claude.aiとClaude Codeでの切り替え方
claude.ai(Web・デスクトップ・スマホアプリ)では、モデル選択メニューから「Fable 5.1」を選ぶだけです。effortも同じメニューで変えられ、Fable 5.1の既定はmediumです。
Claude Codeの既定モデルはOpus 5.5(effortはmedium)です。Fableに切り替えるには/model fableを実行するか、claude --model fableで起動します。深さは/effortで変えられ、Claude CodeでのFable 5.1の既定はhighです。
Claude Codeでは、Fableがusage creditsで課金される場合、モデル選択画面に「Requires usage credits」と表示され、初回に同意を求められます。厄介なのは、-pオプションでの非対話実行やAgent SDKからの呼び出しでは、同意画面を出さずにそのまま課金される点です。自作のスクリプトでモデルをfableに指定していると、請求を見て初めて気づくことになりかねません。
Claude Codeなら「要所だけFable」もできる
Claude Codeには、作業全体はOpus 5.5に任せ、方針を決める前やエラーが続くときだけ、より強いモデルに相談させる「Advisor」機能があります(実験的機能。Claude API経由の接続のみで、Amazon BedrockやGoogle Cloud経由では使えません)。/advisor fableで助言役にFableを指定でき、Opus 5.5を主モデルにした場合は、助言役にFableかOpus 5以降を選べます。
Fableの判断力は欲しいけれど、全工程をFableで回すほどの上限や費用はかけたくない。そんなときの折衷案として使えます。
会話の途中でモデルが切り替わることがある
Fable 5.1とOpus 5.5には、どちらも安全装置(セーフガード)が組み込まれています。サイバー攻撃の手法や、悪用のおそれがある生物学の依頼を検知すると、回答を別のモデルに切り替える仕組みです(Claudeヘルプセンター「Why Claude switched models in your conversation with Fable 5 or Fable 5.1」)。
| 検知された内容 | 切り替え先のモデル |
|---|---|
| 攻撃的なサイバーセキュリティ(エクスプロイト作成など) | Claude Opus 4.8 |
| 生物学・化学・生命科学のデュアルユース領域 | Claude Opus 5 |
- 切り替わると画面に通知が出て、その会話は以降も切り替え先のモデルのまま進みます
- 回答の途中で切り替わった場合、そこまでの入力と出力はFableの単価で数えられます
- 自分が書いたメッセージだけでなく、読み込ませたファイルやWeb検索の結果がきっかけになることもあります
- 自動切り替えは「Settings > Capabilities」でオフにでき、その場合は切り替わらずに会話が一時停止します
まとめ:「Fableを使う理由」があるときだけFableへ
Claude FableとOpusの使い分けは、次の3点に集約できます。
- 普段の作業はOpus 5.5。公式ベンチマークでも実際の事例でもFable 5.1と同等以上で、速く、API単価は5分の2
- Fable 5.1は、数時間以上の自律作業や、原因の分からない難問など「粘り強さ」が要る場面で使う
- ProではFableは従量課金、Maxでも週次上限の50%まで。上限と費用を見ながら使い分ける
モデル選択欄の一番上にあるから、一番良さそうだから、という理由でFableを選ぶと、上限や費用のわりに違いを感じにくいはずです。個人的には、「Fableを使う理由を1行で言えないなら、Opus 5.5で足りる」くらいの線引きがちょうどいいと感じています。まずは今日の作業をOpus 5.5で試して、物足りない場面が出てきたら、effortを上げるかFable 5.1に切り替えてみてください。
なお、会社でClaudeを導入し、社員の使い方やモデル選びのルールづくりまで進めたい場合は、ZIDAIのAI推進室が伴走型で支援しています。
よくある質問(FAQ)
Q1. Claude Fable 5.1とOpus 5.5、結局どちらが賢いですか?
Anthropicの公式ベンチマーク表では、すべての項目でOpus 5.5がFable 5.1を上回っています。独立評価機関Artificial Analysisの総合指数でも、Opus 5.5(58点)がFable 5.1(53点)より上です。ただし、Anthropic自身が「実際に使ったときの差はスコアほど大きくない」としており、長時間の自律作業ではFable 5.1が向く場面もあります。
Q2. Opus 5.5がFable並みなら、Fable 5.1を使う意味はありますか?
あります。数時間〜数十時間かけて任せたい作業や、Opus 5.5のeffortを最大まで上げても結果に満足できない難問では、Fable 5.1を試す価値があります。公式ドキュメントもこの2つをFable 5.1の用途として挙げています。
Q3. ProプランでFable 5.1は使えますか?
使えますが、プランの利用上限には含まれず、usage creditsによる従量課金になります(入力100万トークンあたり$10、出力100万トークンあたり$50)。Opus 5.5は、Proの利用上限の範囲で使えます。
Q4. MaxプランならFable 5.1を使い放題ですか?
使い放題ではありません。週次上限の50%までが追加費用なしで使える範囲で、それを超えるとusage creditsで続けるか、別のモデルに切り替えることになります。Fableは他のモデルより速く上限を消費する点にも注意してください。
Q5. 会話の途中でFableからOpusに切り替わったのはなぜですか?
安全装置が、サイバー攻撃の手法や悪用のおそれがある生物学などの内容を検知したためです。サイバー系はOpus 4.8、生物・化学系はOpus 5に切り替わります。読み込ませたファイルやWeb検索の結果がきっかけになることもあります。なお、Opus 5.5にも同様の安全装置があります。
Q6. Claude Codeではどちらのモデルが使われますか?
既定はOpus 5.5です。Fableはどのプランでも既定ではなく、/model fableなどで自分で選んだときだけ使われます。Opus 5.5で作業しながら要所だけFableに相談させたい場合は、Advisor機能(/advisor fable)も使えます。
Q7. effortはどう使い分ければいいですか?
普段はOpus 5.5の既定値(medium)で十分です。答えが浅い、見落としがあると感じたら、high→xhigh→maxの順に上げてみてください。effortを上げるほど考える時間と消費トークンが増えるため、日常の質問ならlowに下げて速さを優先する使い方もあります。