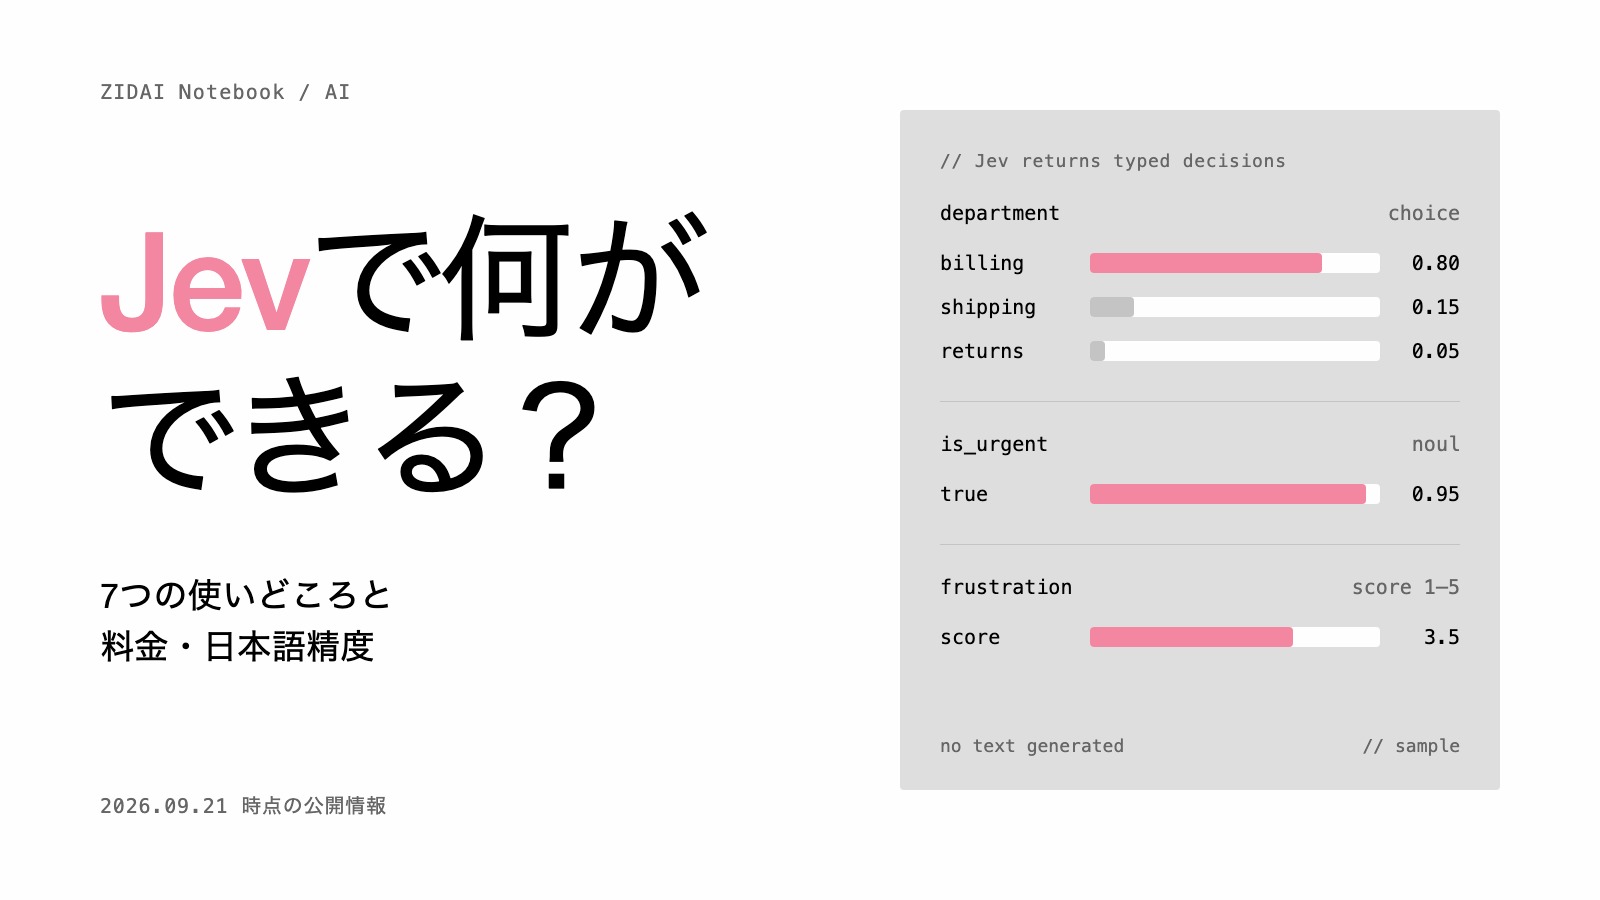
Jevとは、米国のTypeSafe AIが2026年9月15日に発表した、文章を書かずに「型のそろった判断」と「その確からしさ」だけを返すAIモデルです。「この問い合わせはどの部署宛てか」「この申請は急ぎか」といった質問に、あらかじめ決めた選択肢から答えを選び、確率と確信度を添えて返します。
できることは、問い合わせの振り分け、緊急度の採点、承認や返信の要否の一次判定、大量データの分類、AIの出力チェックなどです。文章の作成、計算、日付の比較は苦手で、公式もそう説明しています。
料金は入力100万トークンあたり0.042ドルで、出力は無料です。速さと安さは「最大193.6倍・444.6倍」と公表されていますが、これはTypeSafe自身の評価で、第三者の検証では差はもっと小さくなります。公開から日が浅く、企業名つきの本番導入事例は、2026年9月21日時点で確認できませんでした。
Xで話題のJevを、自社の業務のどこに使えるかという視点で整理しました。公式ドキュメントと第三者の検証をもとに、できること、料金、日本語での精度、苦手なこと、使い始め方を順に見ていきます。公開直後で仕様や提供条件が変わりうるため、情報は2026年9月21日時点のものです。
目次
Jevとは何か?文章を書かず「判断」だけを返すAIモデル
Jevは、TypeSafe AIが「System One(システムワン)モデル」と呼ぶ新しい種類のAIモデルです。System Oneモデルとは、素早く構造化された判断を、ソフトウェアがそのまま使える形で返すモデルのことです(TypeSafe AI公式ドキュメント)。名前は、心理学者ダニエル・カーネマンの著書『ファスト&スロー』の「システム1(速い思考)」に由来します。
開発元のTypeSafe AIは米国の企業で、4,000万ドルのシード資金調達を発表しています(Yahoo!ファイナンス掲載のプレスリリース)。創業者のDiogo Almeida氏は元OpenAIの研究者で、ITmedia AI+はInstructGPTの共著者の1人と紹介しています(ITmedia AI+)。プレスリリースでは、ChatGPTの共同発明者とも表現されています。
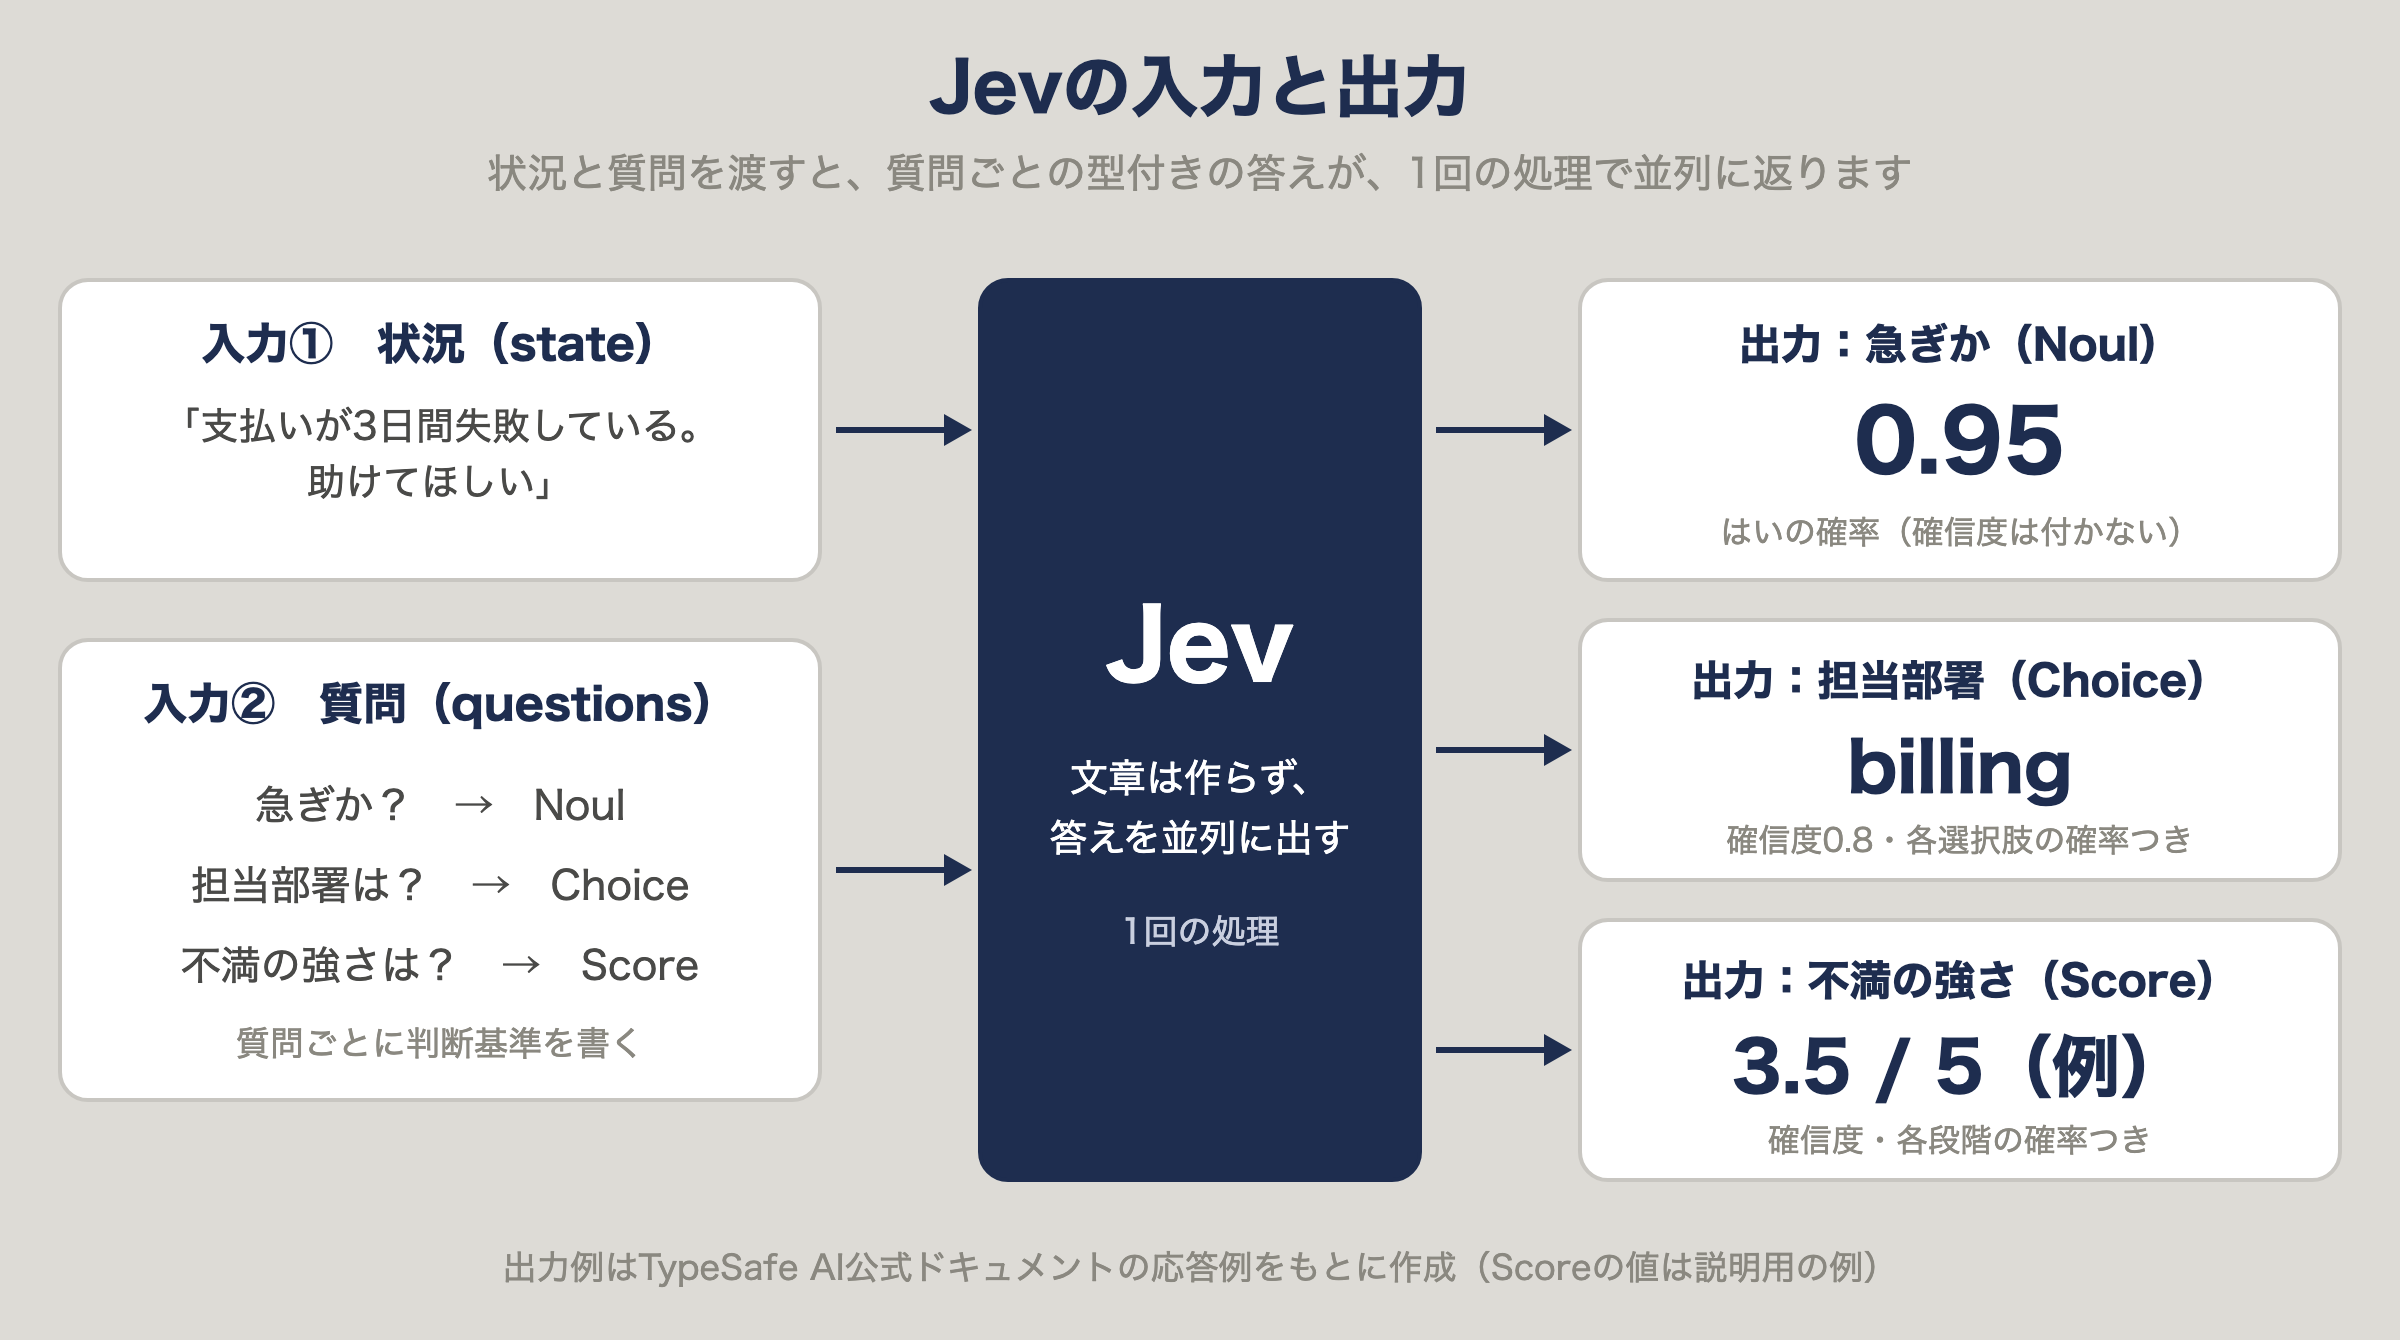
仕組みは、状況(state)と質問(questions)を渡すと、質問ごとの答えが型付きで返ってくるというものです。文章を1語ずつ生成せず、すべての答えを1回の処理で並列に出すため、質問を増やしても待ち時間はほぼ変わらないと公式は説明しています。個人の検証では、質問を1問から40問に増やしても、待ち時間は約0.49〜0.53秒でほぼ一定でした(Zenn)。
訓練にはRLCD(Reinforcement Learning for Calibrated Decisions)という方法が使われています。確率が実際の結果と合うように最適化する強化学習のことです(TypeSafe AI公式ドキュメント)。詳しい訓練手順や論文は、2026年9月時点で公式には示されていません。
提供状況は、9月15日の発表時は待機リストからの招待制(早期アクセス)でした。その後、公式Xが米国時間9月20日に「誰でも利用可能で、待機リストはない」と発表しています(TypeSafe AI公式X)。現行のモデル名はjev-1.13.0です。
Jevが返す3つの判断型
Jevの答えは、Choice・Score・Noulの3つの型のどれかで返ります。どの型も、質問に「判断基準」を書いて渡します。
| 判断型 | 何を答えるか | 返ってくる値 | 業務での例 |
|---|---|---|---|
| Choice(選択) | 用意した選択肢から1つ選ぶ(最大255択) | 選んだ答え、各選択肢の確率、確信度 | 問い合わせを「請求」「返品」「配送」に振り分ける |
| Score(採点) | 2〜10段階の基準に照らして評価する | スコア、各段階の確率、確信度 | 緊急度を5段階で採点する |
| Noul(真偽) | 「この文は真か」を判定する | 0〜1の確率(確信度は付かない) | 「返金の依頼か」「承認してよいか」を判定する |
Noulは、Vercel AI Gatewayでは「Boolean」、Pydantic AIでは「bool(真偽値)」と表記されています。CloudflareやTypeSafe公式のドキュメントでは、Noulのままです。確信度(confidence)とは、確率がどれだけ1つの答えに集中しているかを表す0〜1の値で、正解の確率ではありません。
入力と出力の例
公式ドキュメントの応答例をもとに、入力と出力のイメージを示します(Cloudflare AIドキュメント)。
| 項目 | 内容 |
|---|---|
| 状況(state) | 「支払いが3日間失敗している。助けてほしい」(原文は英語の問い合わせ文) |
| 質問1:is_urgent(Noul) | 急ぎか → 0.95 |
| 質問2:department(Choice) | 担当部署は → billing(確信度0.8) |
ChatGPT・Claude・従来の分類モデルと何が違うのか?
Jevは、ChatGPTやClaudeのような文章生成AI(LLM)を置き換えるものというより、判断だけを高速・低価格で任せるための別の道具です。LangChainの解説も、Jevは「LLMをそのまま置き換えるものではない」としています(LangChain)。
| 項目 | Jev | ChatGPT・Claudeなどの文章生成AI(LLM) | 従来の分類モデル(BERT系など) |
|---|---|---|---|
| 出力 | 型付きの判断と確率・確信度 | 文章(JSONなどの形式も指定できる) | ラベルとスコア |
| 応答時間 | 公式は70〜500ミリ秒。日本語の実測は約0.3〜0.7秒 | 軽量モデルで約0.9〜1.4秒(Supa Lab実測) | 自前運用なら数十ミリ秒の例もある |
| 料金 | 入力100万トークンあたり0.042ドル、出力は無料 | 入力・出力とも従量課金 | 自前のサーバー費用 |
| 学習データの準備 | 不要。質問と判断基準を書く | 不要。指示文を書く | 通常はラベル付きデータで追加学習が必要 |
| 文章の生成・要約 | できない | できる | できない |
| 理由の説明 | 返らない | 文章で説明できる | 返らない |
| 提供形態 | ホスト型のAPIのみ | API・アプリ | 自社運用もできる |
出典:TypeSafe AI公式ドキュメント、Supa Journal、Zenn(acrosstudio)
LLMにJSONで答えさせる「構造化出力」との違いは、形と中身の関係です。構造化出力は、答えの形を決められたとおりにそろえますが、中身は文章を生成して作ります。Jevは、答えが必ず指定した型に合うと公式が説明しています。ただし、型に合うことと、選んだ答えが正しいことは別の話です。
ChatGPTやClaudeなど文章生成AIの選び方は、GPT-6 AstraとClaude Fable 5.1の業務別の選び方で比較しています。
Jevでできること7つ|業務での使いどころ
公式が想定する用途のうち、検証や事例が確認できるものを7つに整理しました。多くは個人や企業の検証、デモの段階で、本番導入は確認できていません。位置づけも合わせて示します。
| # | 使いどころ | 判断型 | 根拠となる検証・事例 | 現時点の位置づけ |
|---|---|---|---|---|
| 1 | 問い合わせ・メールの振り分け | Choice | 日本語48回テスト、Supa Labの208件 | 個人・企業の検証 |
| 2 | 緊急度・不満度の採点 | Score | 日本語48回テスト | 個人の検証 |
| 3 | 承認・返信の要否の一次判定 | Noul | LayerXの社内勉強会、KOIYALの自社判定 | 社内検証(少数件) |
| 4 | 大量データの一括分類 | Choice | 研究論文1,018本の分類 | デモ |
| 5 | AIモデルの振り分け | Choice | DevelopersIO、LangChain | 検証 |
| 6 | AIの出力・操作の検査 | Noul・Score | Good Start Labsの6,003件、Langfuse | 検証 |
| 7 | 1手ごとの判断をリアルタイムで返す | Choice | Browser Use | デモ・検証 |
1. 問い合わせ・メールを部署別に振り分ける(Choice)
受信した問い合わせを「請求」「技術」「営業」などの部署に振り分ける使い方です。Choiceに、選択肢とそれぞれの判断基準を渡します。
日本語での検証が複数あります。日本語16文を3回ずつ、計48回試した検証では、部署の分類は48回すべて期待どおりで、応答時間は中央値285.8ミリ秒でした(Zenn(acrosstudio))。Supa Labは、問い合わせを5部署に振り分けるタスクで100%、依頼を4段階に分けるタスクで95.0%の正解を報告しています(Supa Journal)。
いずれも件数は48回や各20件と少なく、業務メールの実データでの検証ではありません。
2. 緊急度や不満度を点数にする(Score)
Scoreは、2〜10段階の基準に照らして評価します。問い合わせの緊急度を5段階で採点する、といった使い方です。
上の日本語48回の検証では、緊急度の採点は45回が期待と一致しました。ずれた文は、評価基準があいまいでした。たとえば「来月以降の自動更新を停止してください。返金は希望していません。」という文は、答えの確率が2つの選択肢に割れ(0.42〜0.45と0.55〜0.58)、確信度は0.32〜0.37まで下がっています。著者は、これをモデルの失敗ではなく、基準のあいまいさが確信度に表れたものと整理しています。確信度が低い入力を洗い出せば、判断基準の書き漏れを見つける材料にもなります。
3. 「承認してよいか」「返信が必要か」を一次判定する(Noul)
Noulは、「この文は真か」を0〜1の確率で返します。「この申請は自動承認してよいか」「このメールは返信が必要か」のような、はい・いいえの一次判定に向いています。
LayerXは9月18日に公開したブログで、Jevを題材にした社内勉強会に、エンジニア50人以上が参加したと報告しています。紹介された使い方は、「契約書か対象外の書類か」「申請は自動承認できるか」といった二者択一の判断と、確信度が高ければ自動処理し、低ければ人に戻す運用です(LayerXエンジニアブログ)。
KOIYALは、自社の4択判定にJevを並走させ、8件中7件が一致し、応答は0.45〜0.75秒でした。件数が少ないため、筆者は一致率の数字を出す段階ではないと注記しています。不一致の1件は、質問に判断基準が書かれていなかったことが原因です(KOIYAL)。判断基準をどこまで書くかが、結果を左右します。
4. 大量のデータを一括で分類する
人が1件ずつ見ていたら終わらない量のデータを、安く速く仕分ける使い方です。Valyuの検証では、1,018本の研究論文を24のカテゴリに分類する処理が合計0.08ドル、1件あたり中央値256ミリ秒でした(DEV Community)。
これは公開デモでの処理時間と料金の例で、分類の正しさを示す数字ではありません。自社のデータで使う場合は、先に一部を人が分類して、答え合わせをします。
5. どのAIモデルに任せるかを振り分ける(モデルルーティング)
依頼の難しさをJevに見積もらせ、簡単な依頼は軽いモデルへ、難しい依頼は高性能なモデルへ回す使い方です。高性能なモデルの利用を減らして、費用を抑えられます。
DevelopersIOは、Jevを、NeMo Switchyardの分類器(Gemini 3.5 Flash版とDeepSeek V4 Flash版)と比べました。応答は中央値0.643〜0.674秒で、Gemini版より約3倍、DeepSeek版より10〜11倍速く、1回あたり0.000025〜0.000027ドルでした。精度は「同等かやや劣る」とされ、難易度ごとに1つの会話しか試していない点も明記されています(DevelopersIO)。
LangChainも、エージェントのモデル振り分けと、ツールを実行する前の危険度の判定にJevを使う構成を紹介しています(LangChain)。
6. AIの出力や操作を検査する(ガードレールと評価)
AIエージェントが実行しようとしている操作が安全か、AIの回答が基準を満たしているかを、別のモデルで確認する使い方です。LLMを審査役にする方法(LLM-as-a-judge)の代わりに使います。
Langfuseの解説によると、Good Start Labsの実験(6,003件のルーブリック確認)で、JevはClaude Fable 5.1の判定と91.5%一致しました。回答100万件あたりの費用は、Jevが160ドル、Claude Fable 5.1が33,000ドル、GPT-5.6 Lunaが400ドルです。DeepSeek V4.1 Flashは一致率93.5%で、わずかに高い代わりに費用も高くなっています(Langfuse)。
ここでの一致率は正解率ではなく、別のモデルの判定との一致度です。Langfuseは、Jevは強制的な二択で「不明」の選択肢がなく、判断できない場合も答えてしまうことと、長い記録では精度が下がる可能性も挙げています。
7. アプリやAIエージェントの「1手ごとの判断」をリアルタイムで返す
画面操作の次の一手や、ゲームの操作のように、1秒未満で判断を返し続ける使い方です。Browser Useのjev-ultrafastは、Google Flightsでチューリッヒからロンドンへの便を検索する作業で、所要時間の中央値が9.450秒から7.092秒に約25%縮み、ブラウザ操作の呼び出しは1,092回から101回に減りました。最適化した版でのJevの判断の遅延は中央値178ミリ秒です(Browser Useの計測資料)。
この25%の短縮は、元の版も最適化した版もTypeSafeのモデルを使っており、Jevの使い方を改良した効果です。LLMとJevの比較ではありません。Browser Use自身による、1つの課題での少数回の計測です。TypeSafeの公式デモでは、ゲーム「Doom」の操作やWikipediaのリンク選びもJevに判断させています。MindStudioは、紹介するコミュニティのデモがすべてシミュレータ上のもので、実機での性能は確かめられていないと指摘しています(MindStudio)。
7つのうち、業務担当者が最初に試しやすいのは、1〜3の振り分け・採点・一次判定です。自社の受信メールや申請書のように、答えの選択肢と判断基準を書き出せる業務から始められます。
海外と国内では、どこまで試されているのか?
公式サイトと第三者の記事のいずれでも、企業名つきの本番導入事例は、2026年9月21日時点で確認できませんでした。確認できたのは、次の4種類です。
| 種類 | 主体 | 内容 | 出典 |
|---|---|---|---|
| 製品への組み込み | Vercel | AI Gatewayでモデルtypesafe-ai/jevとして提供(9月16日)。リクエストごとにゼロデータ保持を指定できる | Vercel |
| 製品への組み込み | Cloudflare | Workers AIでモデルtypesafe/jevとして提供 | Cloudflare |
| 製品への組み込み | OpenRouter | ベータ版としての提供開始を告知(米国時間9月17日) | OpenRouter公式X |
| 製品への組み込み | Dify | 質問分類ノード用のプラグインを公開 | Dify Marketplace |
| 第三者の検証 | Supa Lab | 4タスク208件で軽量LLM4種と比較 | Supa Journal |
| 第三者の検証 | Good Start Labs | 6,003件のルーブリック判定 | Langfuse |
| 第三者の検証 | OpenRouter | 自社の評価ツールで、OpenRouter上の人気LLMと比較。次に速いモデルの5倍以上の速さ、精度は5モデルとも近い範囲、費用は2番目に安い(9月19日・米国時間) | OpenRouter公式X |
| 国内の取り組み | LayerX | 社内勉強会にエンジニア50人以上が参加 | LayerXエンジニアブログ |
| デモ | Browser Use、TypeSafe公式 | Google Flightsの操作、Doom、Wikipediaのリンク選び(Wikiracing) | Browser Use、公式ブログ |
Xでは、創業者Diogo Almeida氏の発表投稿が約3,800万回表示されました(2026年9月21日時点、X)。個人開発者による実装例の共有も相次いでいます。ただし、話題の大きさと、業務での実績は別のものです。導入を検討する場合は、次の章以降の料金、精度、注意点を、自社のデータで確かめてください。
Jevの料金はいくらか?月間件数別の試算
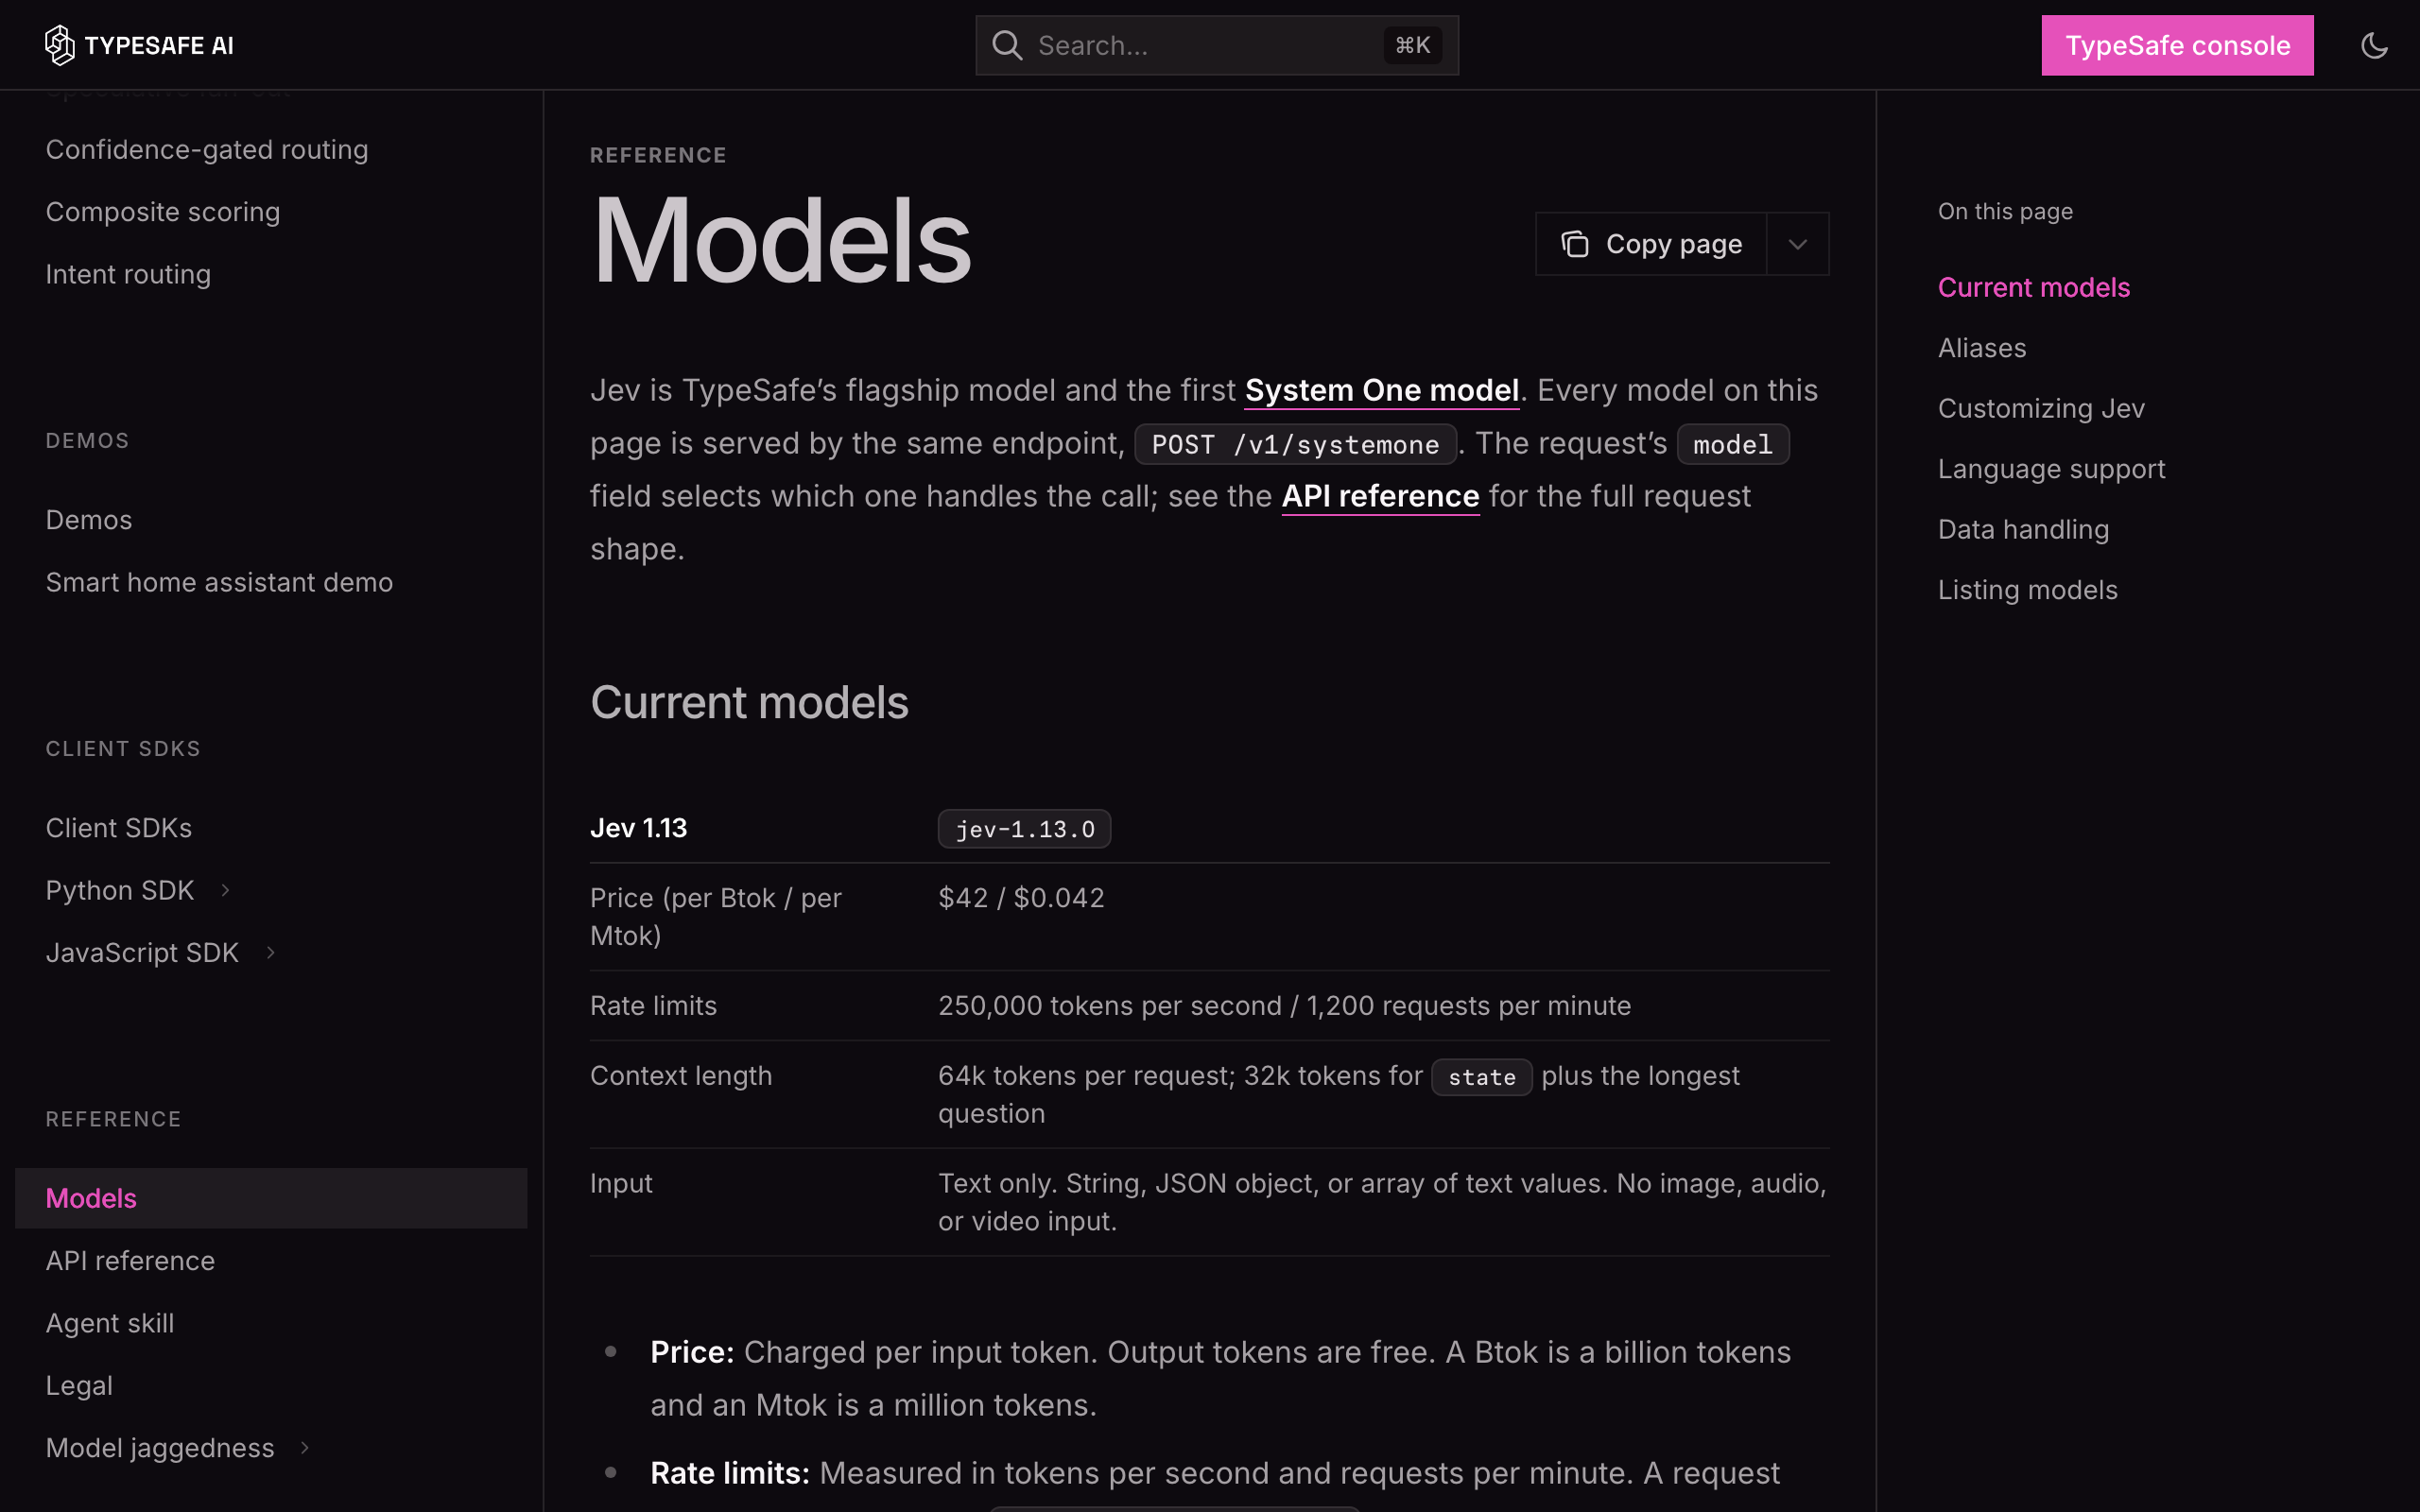
Jevの料金は、入力トークンだけにかかります。入力は100万トークンあたり0.042ドル(10億トークンあたり42ドル)で、出力は無料です(TypeSafe AI公式ドキュメント)。トークンとは、AIが文章を処理する単位です。実際の数はAPIの応答(usage)で確認できます。1リクエストの上限は、状況(state)と最長の質問で32,000トークン、全体で64,000トークンです。
公式の単価から、月間件数別の入力料金を計算しました。1件あたりの入力量は、状況と質問を合わせた数を仮定しています。
| 月間の件数 | 1件1,000トークンの場合 | 1件5,000トークンの場合 |
|---|---|---|
| 1万件 | 0.42ドル(約63円) | 2.1ドル(約315円) |
| 10万件 | 4.2ドル(約630円) | 21ドル(約3,150円) |
| 100万件 | 42ドル(約6,300円) | 210ドル(約31,500円) |
| 1,000万件 | 420ドル(約63,000円) | 2,100ドル(約315,000円) |
円換算は1ドル150円と仮定した試算で、ZIDAIが公式の単価から計算したものです。
実測とも大きくずれません。日本語48回の検証では、合計約0.0015ドル、1回あたり約0.00003ドルでした。Supa Labの検証では、1,000件あたり0.019〜0.033ドルです。
試算に含まれないものもあります。質問文もトークンに数えられるため、質問を増やすと入力が増えます。前処理、失敗時の再試行、人が確認する工数、LLMと併用する場合のLLM側の費用は別にかかります。「出力無料」の期限は公式に記載がなく、価格は今後変わる可能性があります。
無料枠については、Vercel AI Gatewayでは9月25日まで無料と、Vercelが告知しています(Vercel Developers公式X)。新規登録の5ドル分のクレジット(約1億2,000万トークン相当)も報じられていますが、公式ページでは確認できていません(gihyo.jp)。
日本語でも使えるのか?精度はどこまで信頼できるか
日本語でも使えますが、公式は英語での精度が最も高いとしており、本番の前に自社のデータで試す必要があります。公式ドキュメントには、英語が主な学習言語で精度が最も良く、日本語などのCJK文字を含む他の言語は「対応するが、同等ではない」と書かれています(TypeSafe AI公式ドキュメント)。
日本語での検証は増えていますが、いずれも件数は小さく、最大でも208件です。
| 実施者 | 内容 | 結果 |
|---|---|---|
| acrosstudio(Zenn) | 日本語16文×3回=48回 | 部署48/48、返金依頼48/48、緊急度45/48一致。中央値285.8ミリ秒 |
| Supa Lab | 日英各20件のタスクを含む4タスク208件 | 正解率95〜100%。日本語の各20件は全問正解で、誤りは英語のroutingの2問 |
| fyve | 問い合わせ25件の振り分け | 日英とも96%一致。往復の中央値は約0.4秒 |
| KOIYAL | 自社の4択判定8件 | 7件一致。判断基準が未記載の1件が不一致 |
| DevelopersIO | 書類の項目突合107件 | 文字列が同じかの判定で99.1%、意味が同じかの判定で90.6%。数量の差(合計500kgと明細計450kg)の見落としがあった |
精度は「聞き方」で変わる
同じ内容でも、質問の書き方で結果が変わります。合成したフィッシングメール2,000通の独立ベンチでは、1つの質問で判定した場合のJevの正解率は62.6%(Claude Haiku 4.5は81.3%)でした。質問を5つに分け、それぞれの重みを1,000件のデータで当てはめると、Jevは95.0%(Claude Haiku 4.5は93.2%)に上がっています(XenoSpectrum)。ただし、このデータは「作り方からほぼ分けられる」性質があり、一般化には限界があると指摘されています。
個人情報の判定を試した例では、「個人情報を含む」という判定の確率が、挨拶文で5%、氏名の「山田太郎様」を「ご担当者様」に置き換えた文で34%、架空の氏名を実在しそうな氏名に置き換えた文で88%と、書き方で大きく動きました(DevelopersIO)。質問は1つの論点に絞り、判断基準を具体的に書くことが基本です。
確信度で、自動処理と人の確認を分ける
確信度と確率は、自動処理と人の確認を分ける基準として使います。公式ドキュメントは、確信度が高ければ自動実行、中ぐらいなら確認、低ければ人に回す運用を勧めています。Noulのコード例では、確率が0.8以上ならはい、0.2以下ならいいえとして自動処理し、その間は人が確認します。ただし、閾値は間違えたときの損失の大きさで決めるもので、固定の規則ではありません。送金の承認のような取り消しにくい操作の例では、確信度が高い場合でも、確認を挟んでから実行する設計になっています(TypeSafe AI公式ドキュメント)。
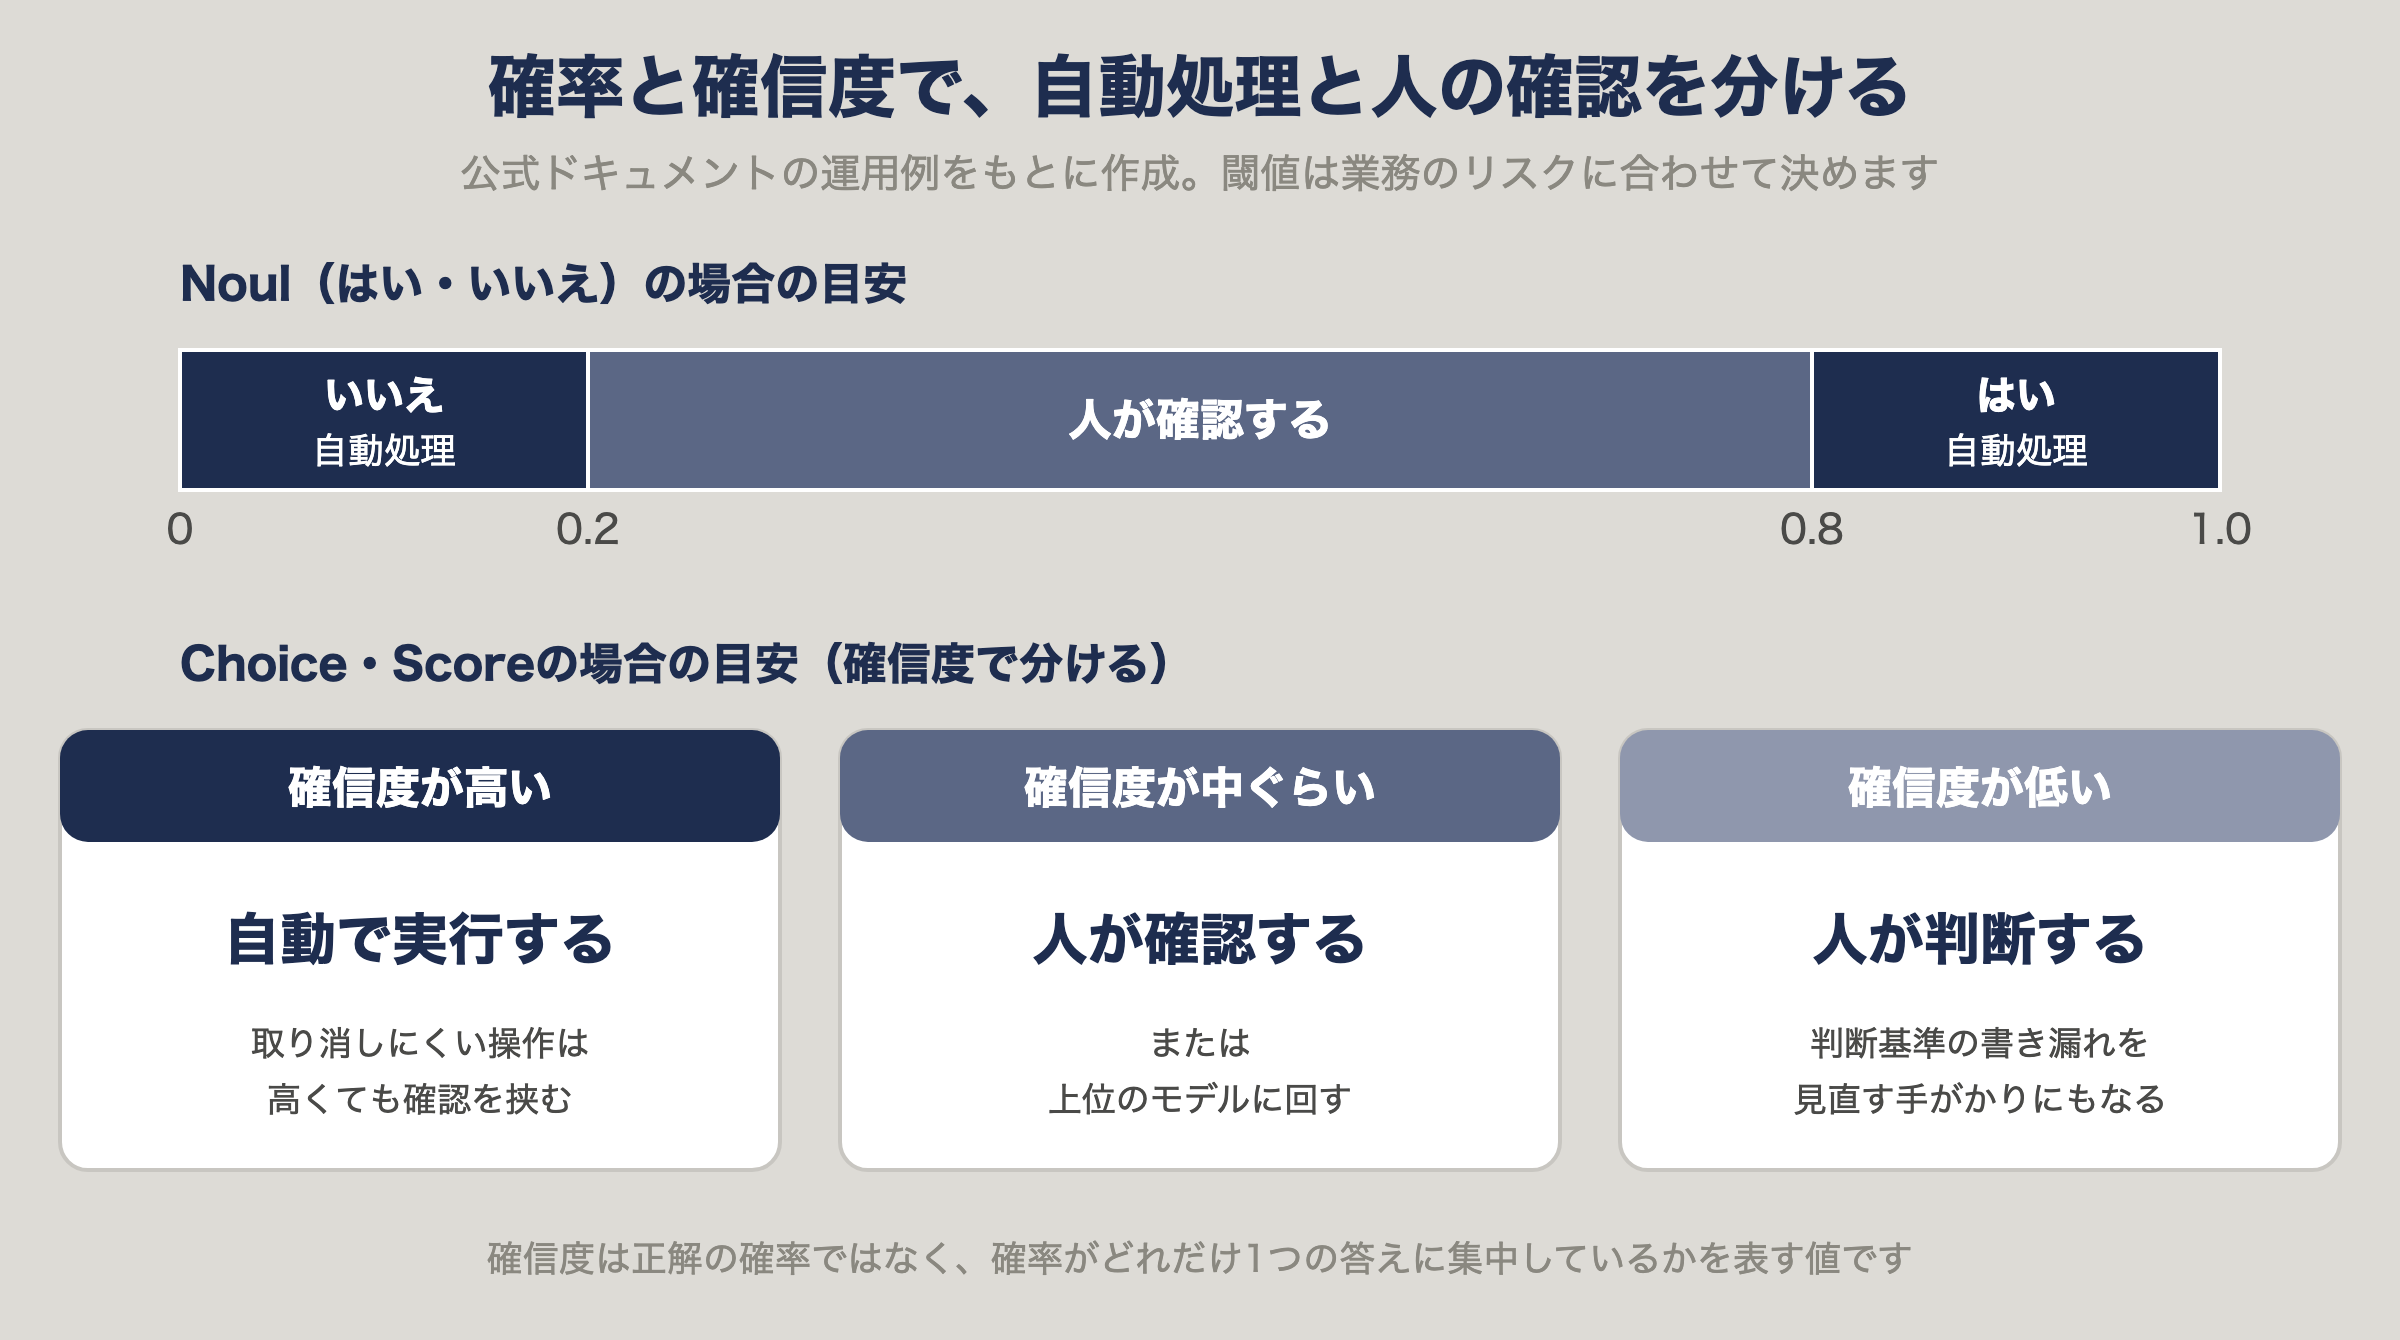
確信度は正解の確率ではなく、判断の集中度です。Supa Labは、自社の4タスクでは確信度が実際の正解率とよく合っていたと報告しています(較正誤差ECEが0.002〜0.047)。一方、GitHubで公開された個人の検証では、性質の違うデータ(合成した問い合わせ900件)で、確信度と正解率のずれが大きくなりました(jev-ood-calibration)。業務データでは、確信度の閾値を自分で確かめてから使ってください。
「193.6倍速い・444.6倍安い」はどこまで本当か?数字の読み方
Jevの速さと安さの倍率は、TypeSafe自身の評価にもとづく「上限側」の数字で、第三者の検証では小さくなります。倍率は出典ごとに違うため、何と何を比べた数字かを確認する必要があります。
| 数字 | 出どころ | 条件 |
|---|---|---|
| 最大193.6倍高速・444.6倍安価 | 公式サイト、公式ブログ | TypeSafe自身の4つの業務フロー評価。公式は「実際の利用で得られる上限側」と説明している |
| 40〜200倍高速 | 公式ブログ | 「System One向きの質問」で、同じ水準の知能を出す場合の範囲 |
| 20〜200倍高速・40〜400倍安価 | 創業者のX投稿 | 発表時の投稿での表記。下限が公式ブログと異なる |
| 約3〜11倍高速 | Supa Lab、DevelopersIO、OpenRouter | 軽量LLM(Claude Haiku 4.5など)やGemini 3.5 Flash、DeepSeek V4 Flashとの実測。OpenRouterは、比較したLLMのうち次に速いモデルの5倍以上と報告 |
| 料金差は約1.6〜206倍 | Good Start Labs(回答100万件あたり) | Jev160ドルに対し、DeepSeek V4.1 Flash 260ドル、GPT-5.6 Luna 400ドル、Claude Fable 5.1 33,000ドル |
同じ「◯倍」でも、比べる相手が高性能な推論モデルか軽量モデルかで、大きく変わります。料金差が約1.6倍から206倍まで開くのも、比べる相手の価格が違うためです。
精度の「67.8%」は、TypeSafeの評価で「参照解との一致度」を表す数字で、正解率ではありません。参照解は、GPT-6 AstraとClaude Fable 5.1の回答の平均です。公式ブログも、評価用の業務フローを作った人の偏りがありうる点を認めています。
「ハルシネーション(もっともらしい誤り)がゼロ」という表現は、何を保証しているのかを分けて読む必要があります。公式ブログによると、この数字は実測値ではなく、答えの形が必ず指定した型に合うという保証です。選んだ答えが正しいことまでは保証していません。
Jevが苦手なことと、導入前の注意点
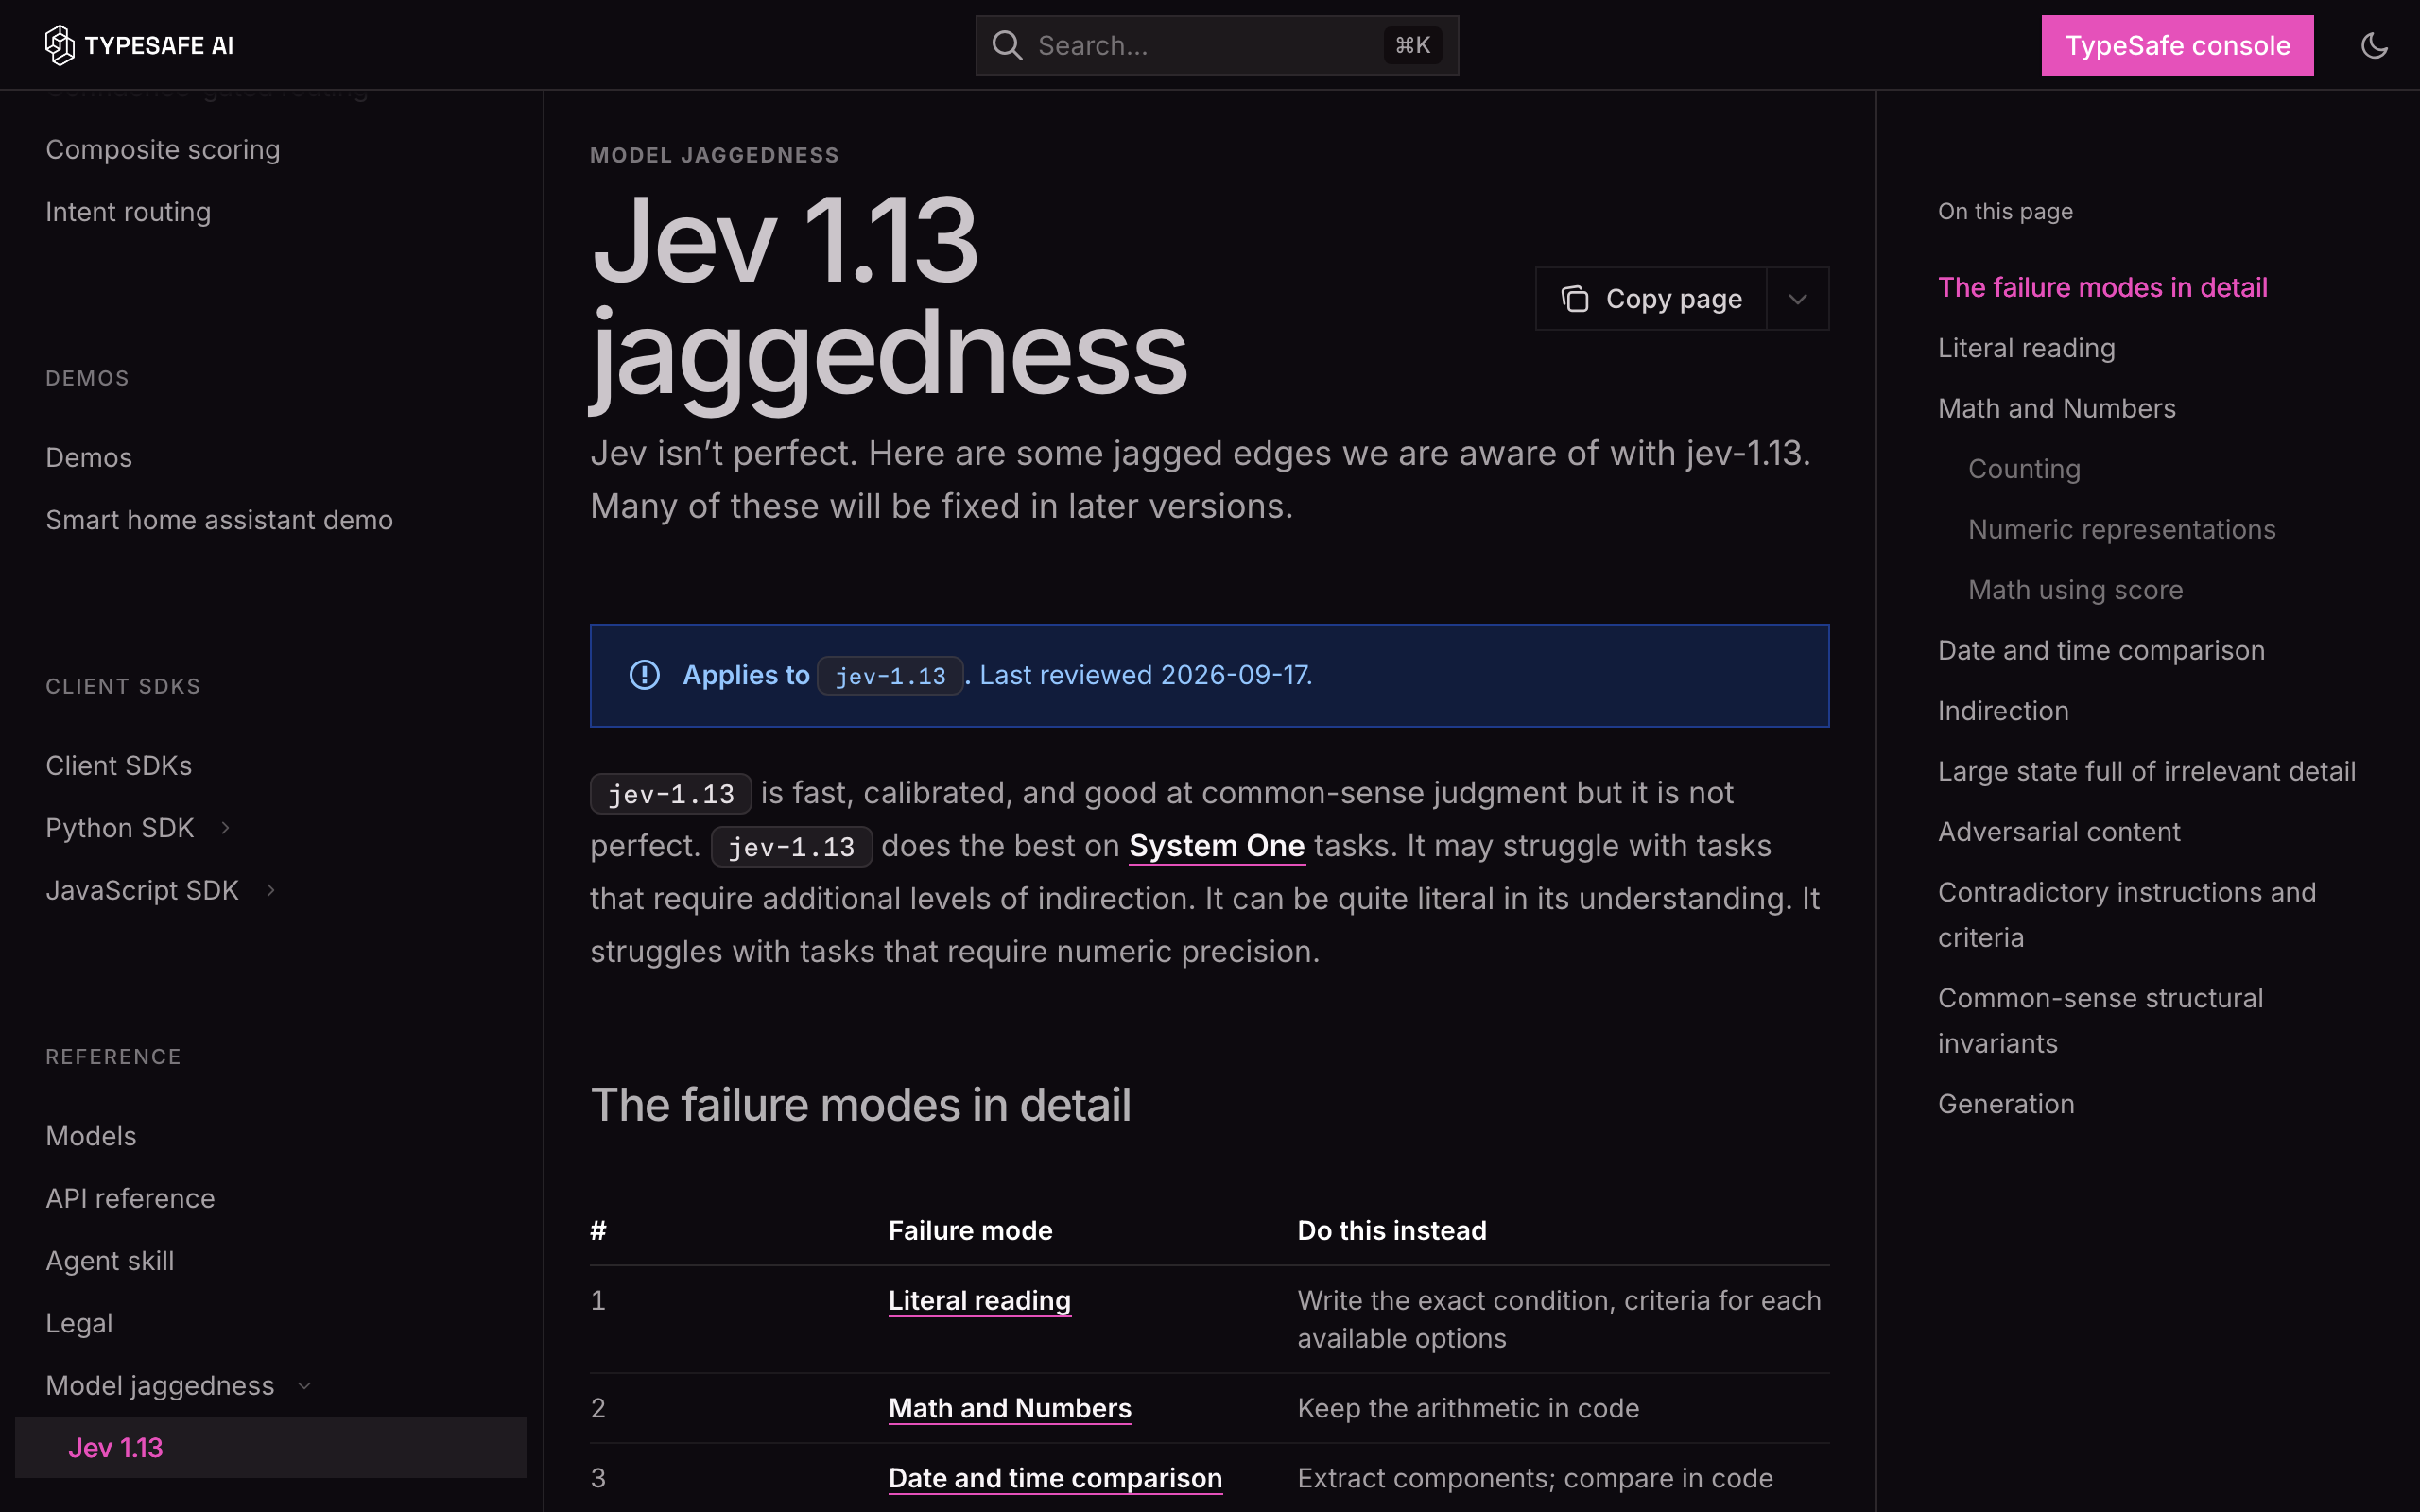
Jevの苦手なことは、公式ドキュメントの「Jev 1.13の苦手な点」に書かれています。導入前に押さえておきたい点は次のとおりです(TypeSafe AI公式ドキュメント)。
- 否定や条件の言い回しは字面どおりに解釈し、書き手の意図までは汲みません。
- 文字数や出現回数を数える、日付の前後を判定する処理は信頼できません。数値や日付の判断は、プログラム側に残します。
- 状況に関係のない内容が増えるほど、精度が下がります。送る前に絞り込みます。
- プロンプトインジェクション(AIに不正な指示を紛れ込ませる攻撃)を、既定では敵対的とみなしません。
- 質問の指示と判断基準が食い違うと、判断が乱れます。
- 文章の生成は訓練されておらず、向きません。入力もテキストのみで、画像・音声・動画は事前にテキストにします(入力形式はModelsページ)。
運用面では、次の3点も押さえておきます。
- 答えと確率は返りますが、理由は返りません。監査や異議申し立てが必要な判断は、単独で任せず、人の確認を挟みます。
- 最新版を指す「jev-latest」は将来変わる可能性があります。閾値を決めた後は、モデルの版を固定して運用します。
- Jevはホスト型のAPIで、自社のサーバーには置けません。公式は、顧客のリクエストと応答でモデルを訓練しないとしています。ゼロデータ保持はエンタープライズ向けに提供され、Vercel AI Gatewayではリクエストごとに指定できます。Supa Journalは、ホスト型のAPIが米国リージョンのみで、EUや日本にデータを置く要件がある場合は選べないと指摘しています(Supa Journal)。個人情報や機密を送る場合は、データの保存場所を含めて、社内の情報セキュリティ担当と確認してください。
社内で生成AIを使う際のルールづくりは、生成AIの社内利用ルール、経営者が最低限決めておくべき7項目にまとめています。
ルール・専用分類モデル・Jev・LLMはどう使い分けるか?
判断の中身と、手元の材料に応じて、次のように選びます。これはZIDAIによる整理で、考え方の一例です。
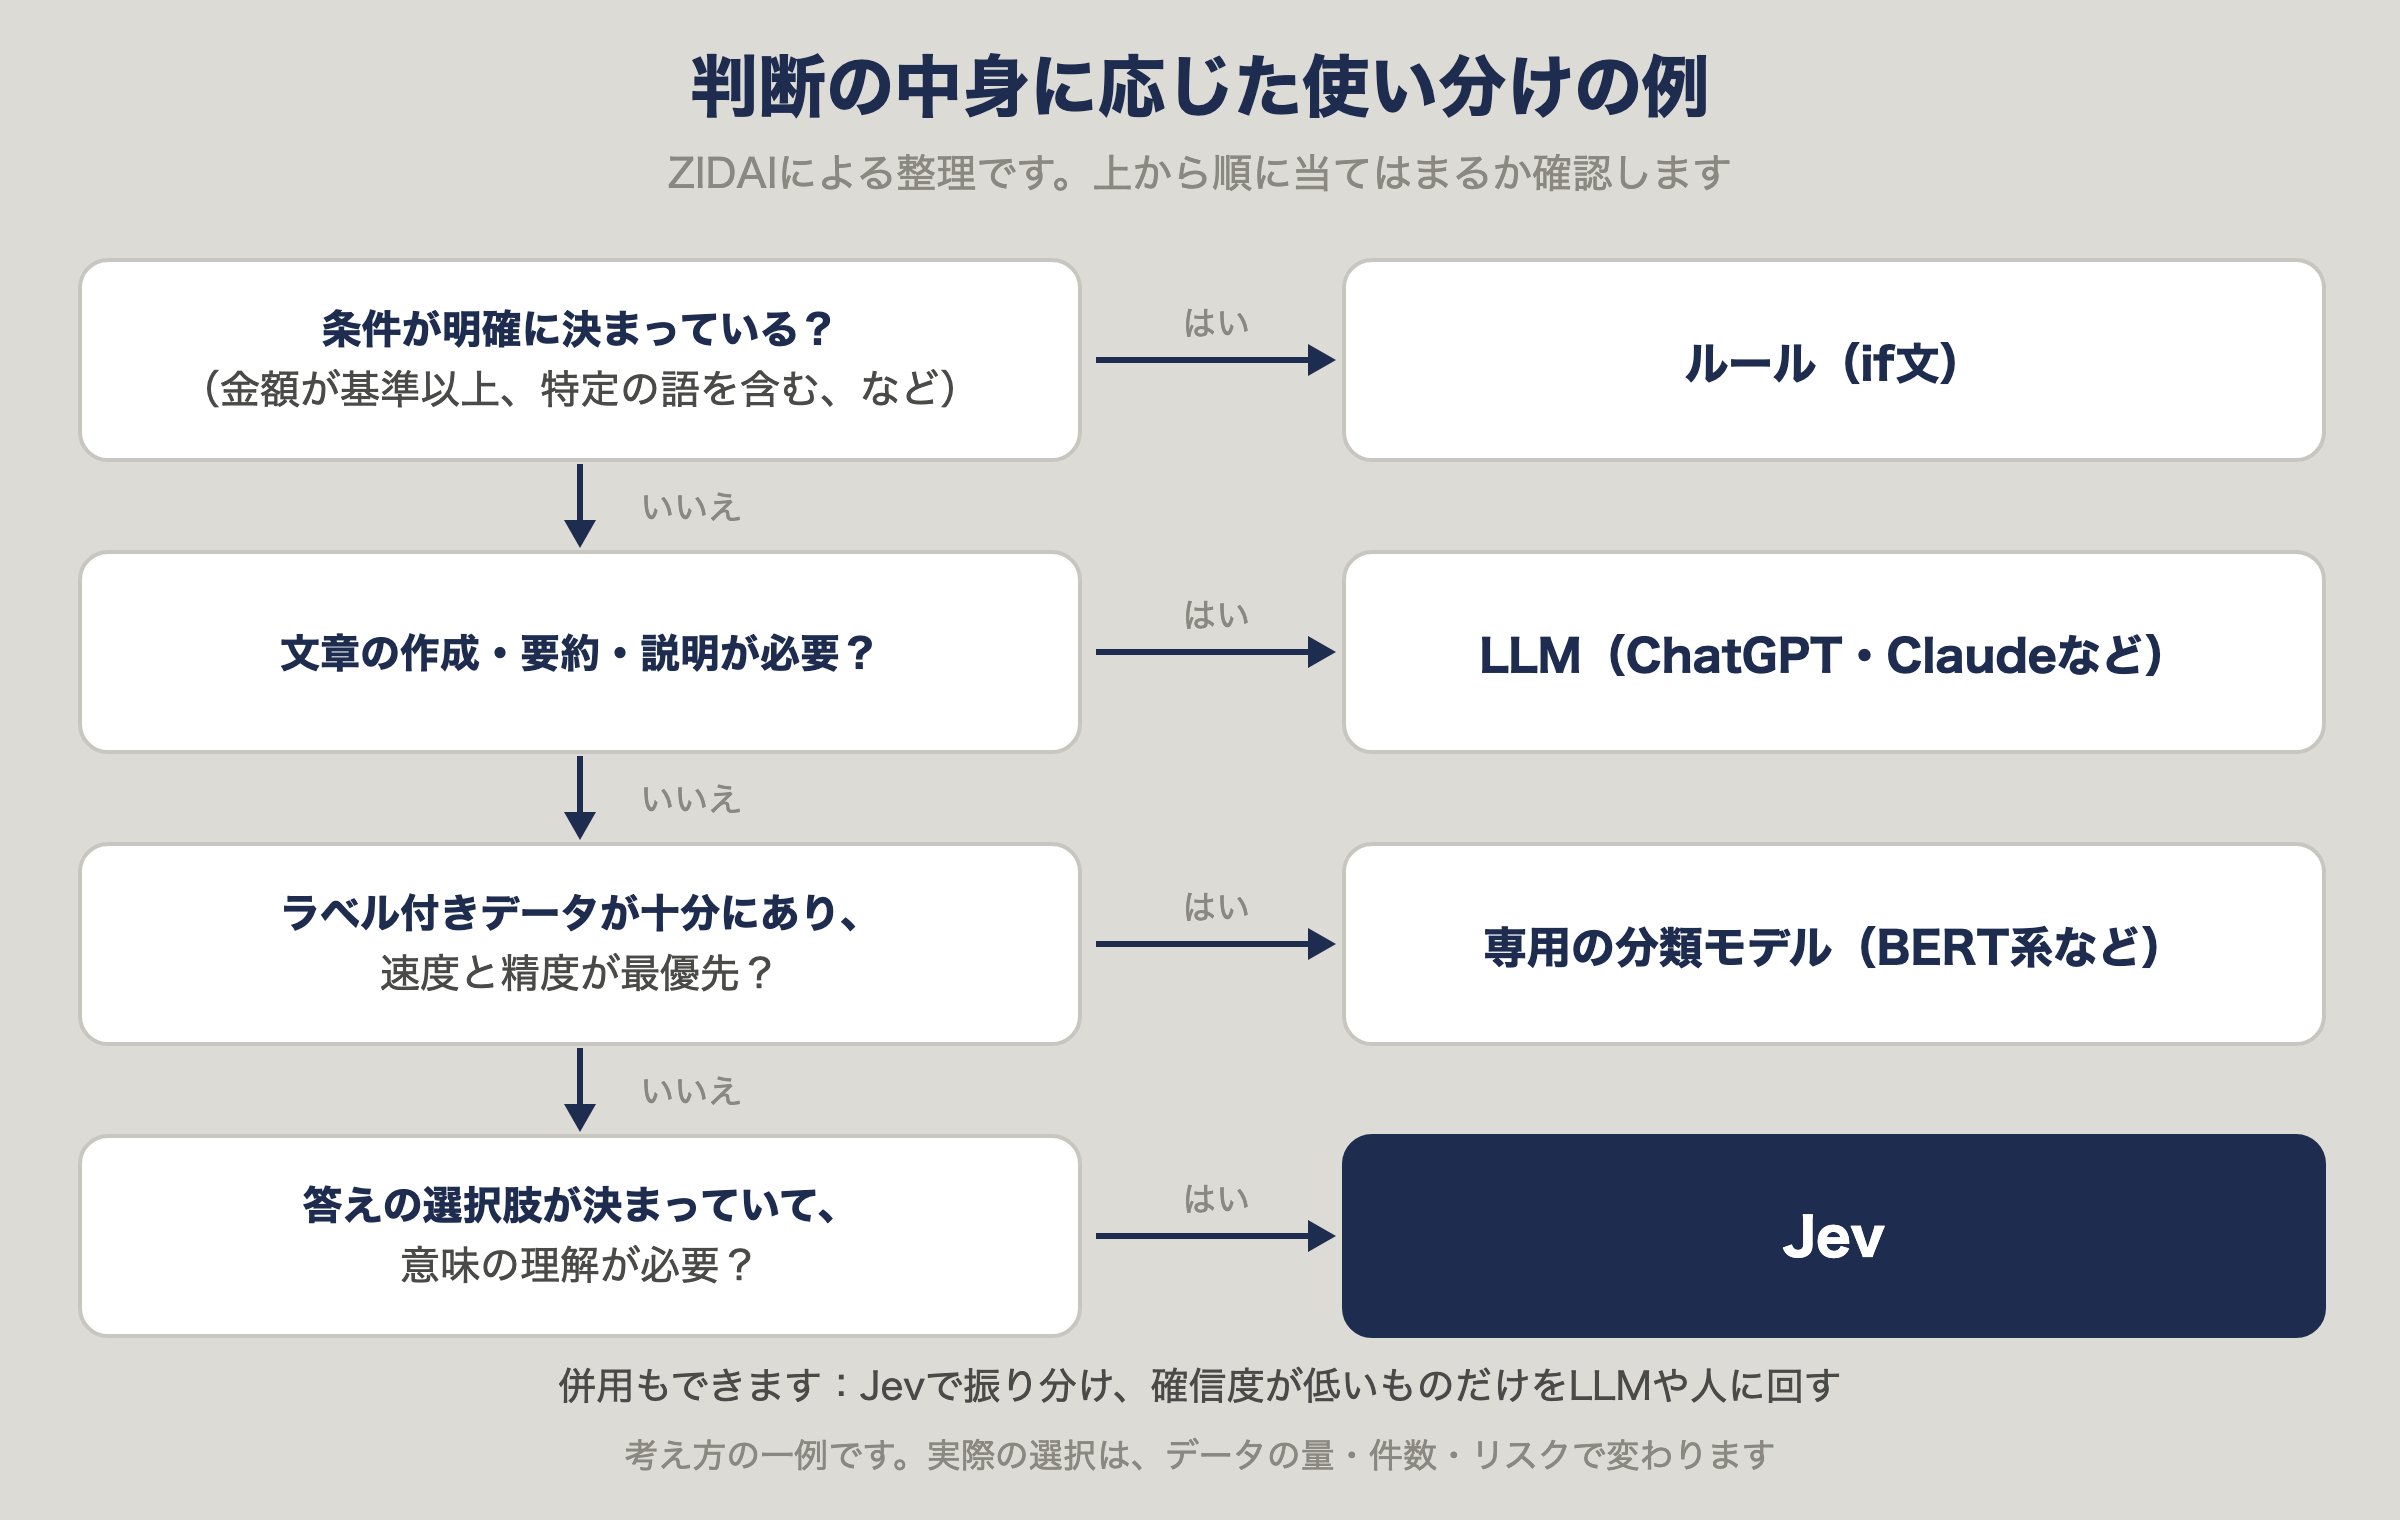
| 選択肢 | 向いている場面 | 注意点 |
|---|---|---|
| ルール(if文) | 条件が明確に決まっている。金額が基準以上、特定の語を含む、など | 言い回しの揺れに弱い |
| 専用の分類モデル(BERT系など) | ラベル付きのデータが十分にあり、速度と精度を最優先したい | データの準備と、学習・運用の手間がかかる |
| Jev | 答えの選択肢が決まっていて、意味の理解が必要。学習データがまだ無い、または早く試したい | 苦手な処理(計算・日付)はコードに任せる。理由は返らない |
| LLM | 文章の作成、要約、説明、情報の抽出が必要 | 応答が遅く、費用が高い |
Supa Journalは、LoRAで学習した専用の分類モデル(xlm-roberta-large)が、LLM(Claude Sonnet 4.6)より高い精度と速い応答を出した、英語データの海外ベンチを引用しています。学習データがそろっている場合は、専用の分類モデルの方が向くことがあります。
併用もできます。最初にJevで振り分け、確信度が低いものだけをLLMや人に回せば、費用を抑えながら、難しい判断の質を保てます。
Jevを使い始めるには?最初の3ステップ
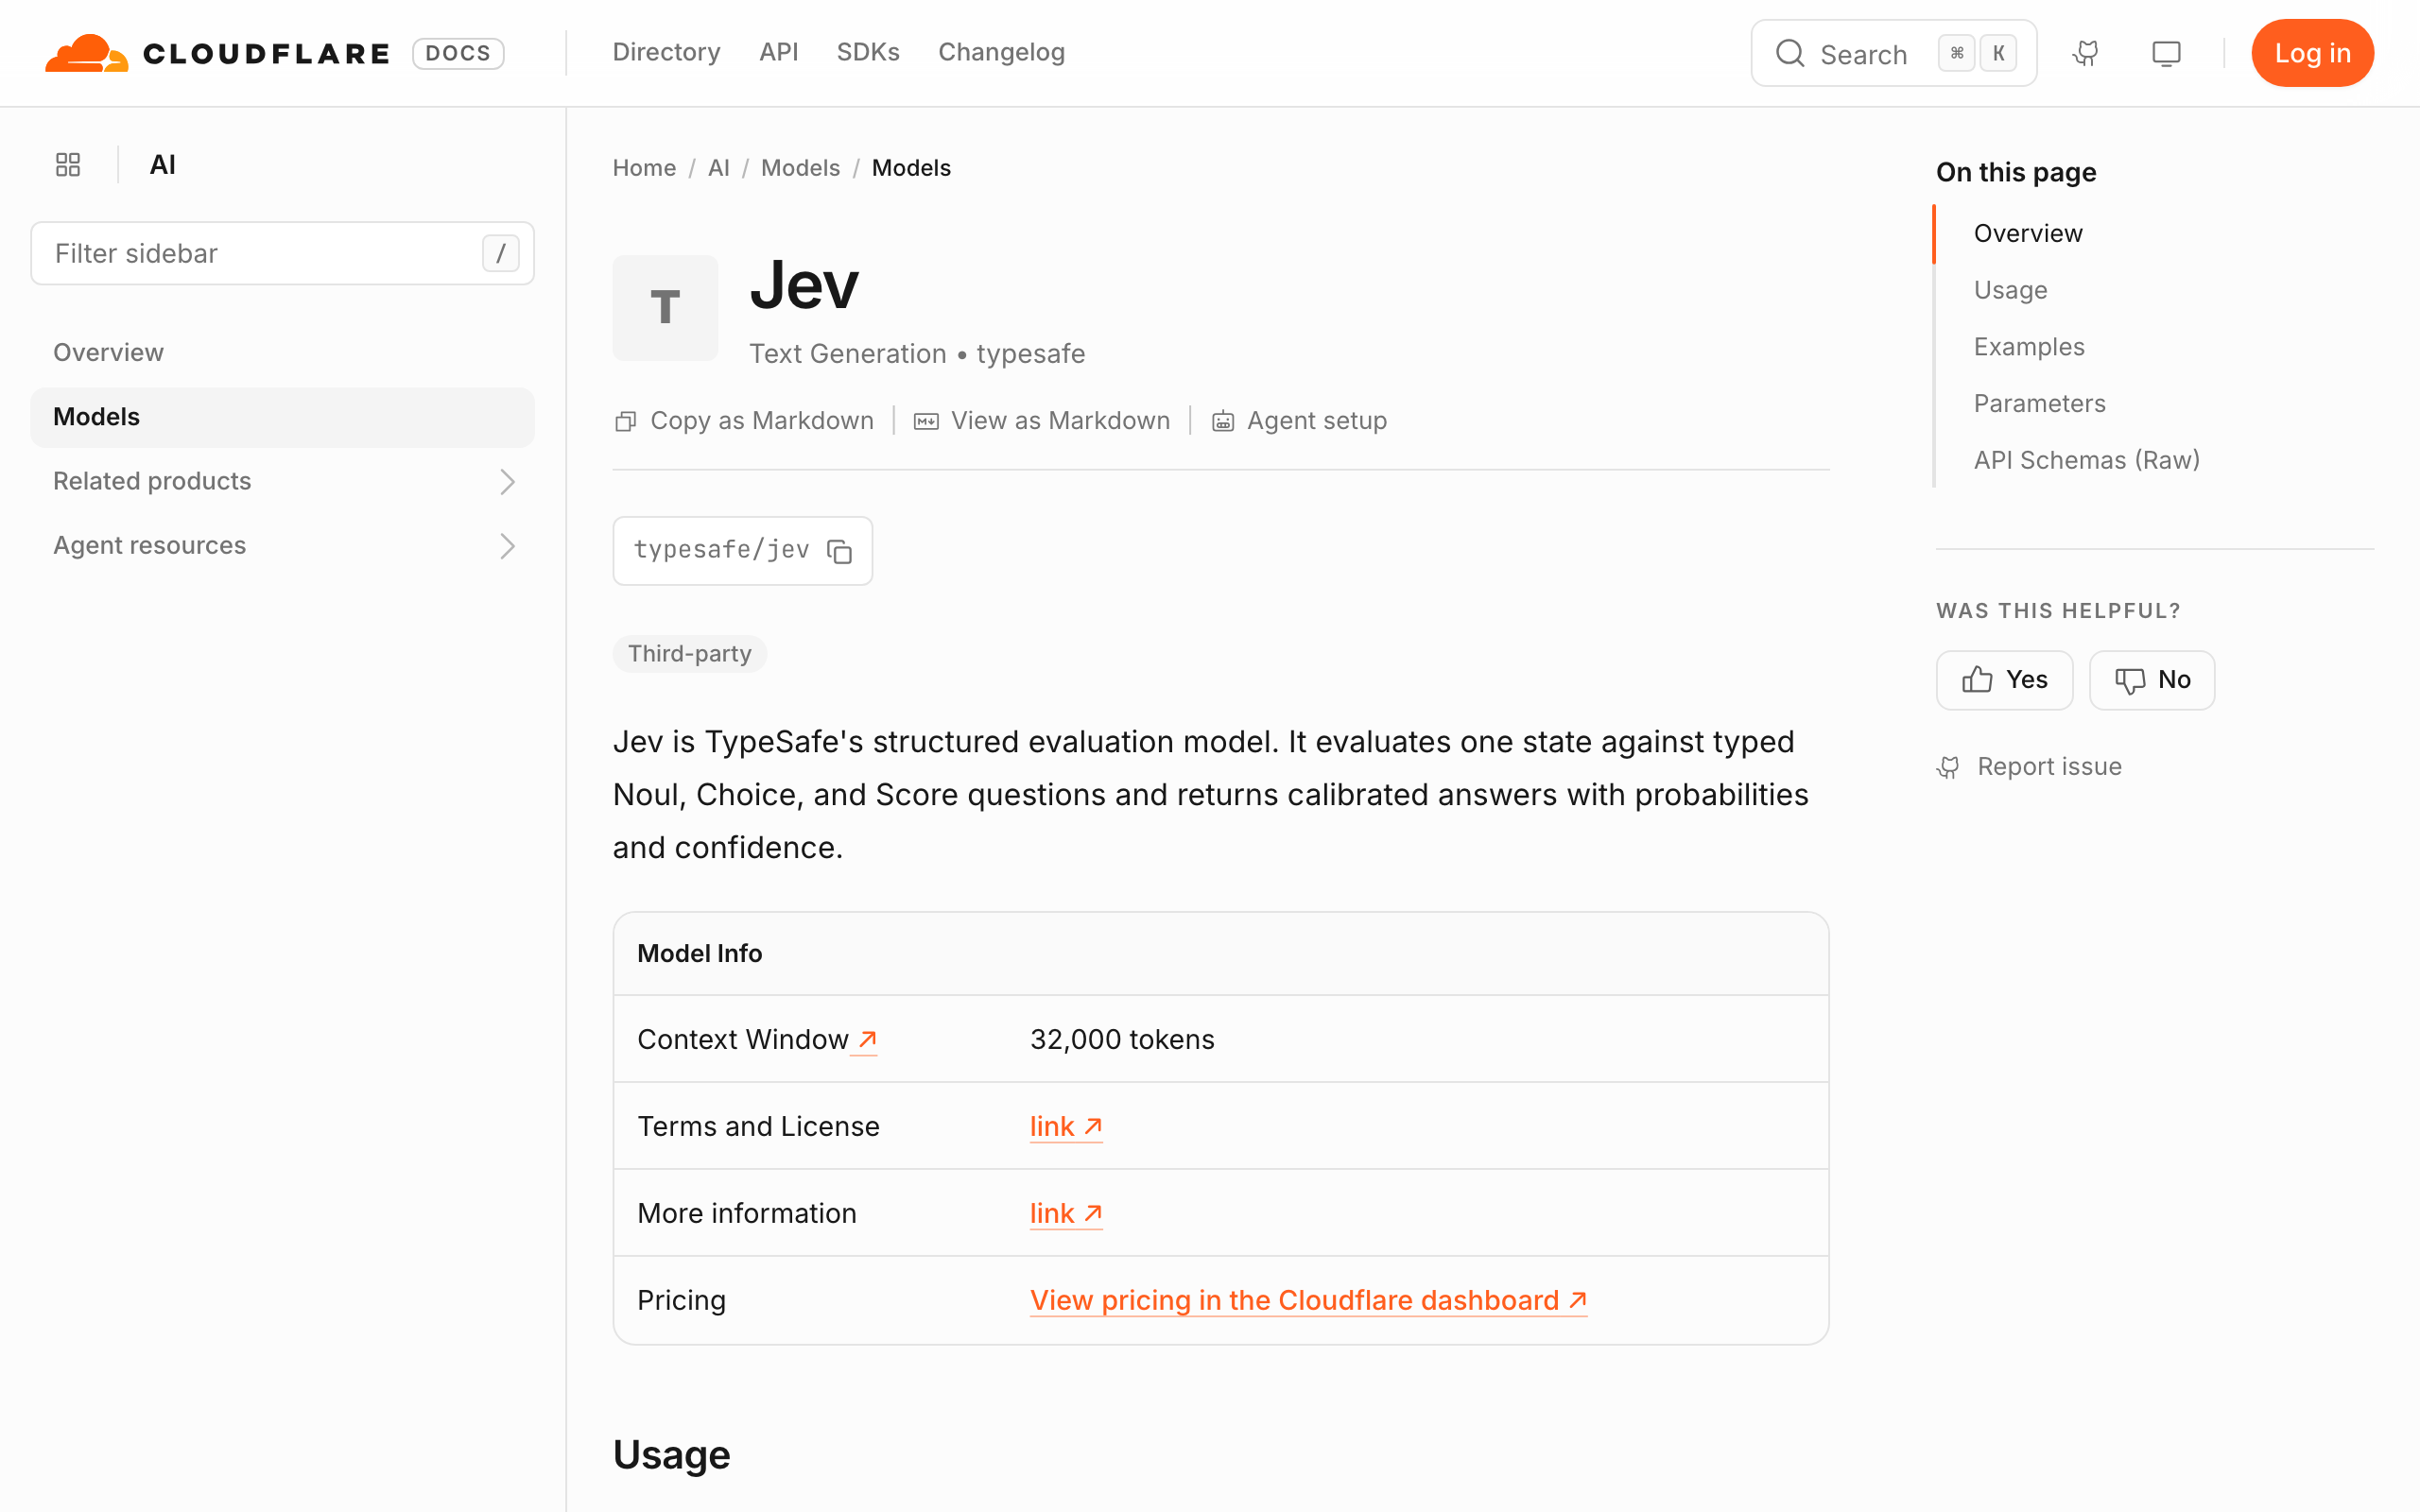
Jevは、公式コンソールでアカウントを作れば、すぐに試せます。待機リストはなく、APIの呼び出し先はhttps://api.typesafe.ai/v1/systemoneです(クイックスタート)。
ステップ1:APIキーを発行して、Playgroundで試す
TypeSafe AIのコンソールでアカウントを作り、APIキーを発行します。PythonとJavaScriptのSDKも用意されています(JavaScript SDK)。Cloudflare Workers AI、Vercel AI Gateway、OpenRouter(ベータ)、Difyなど、すでに使っている基盤から呼ぶ方法もあります。
ステップ2:自社のデータ20〜50件で試す
先に人が答えを付けたデータを、20〜50件用意します。件数はZIDAIの目安です。質問は1つの論点に絞り、判断基準を書いて、答え合わせをします。確信度が低い入力は、判断基準の書き漏れの手がかりになります。
ステップ3:確信度の閾値を決めて、並走で確かめる
確信度の閾値を決め、低いものは人に回す設計にします。本番の判断は今までどおり人が行いながら、Jevを並走させて結果を比べると、リスクを抑えて確かめられます。
最初の進め方は、生成AI導入は何から始めるべきか?経営者の最初の90日でやること7つでも整理しています。
まとめ
Jevは、文章を書かずに、選択肢から答えを選んで確率と確信度を返すAIモデルです。できることは、問い合わせの振り分け、緊急度の採点、承認や返信の要否の一次判定、大量データの分類、AIの出力チェックなどです。料金は月10万件・1件1,000トークンで約4.2ドルと、入力の単価は非常に安く、日本語でも使えます。
一方で、速さと安さの倍率は自社評価の上限で、日本語の検証は最大でも208件、企業名つきの本番事例はまだありません。計算や日付は苦手で、理由も返りません。ZIDAIとしては、Jevを「意味のわかるif文」と捉えて、小さな振り分けから試すのが現実的だと考えています。答えの選択肢と判断基準を書き出せる業務を1つ選び、20〜50件で並走させてみてください。
「自社のどの業務でJevのような判断特化のAIが使えるか」「LLMとどう使い分けるか」を整理したい場合は、ZIDAIのAI推進室で、業務の棚卸しから定着までを一緒に進められます。まずは、社内の問い合わせや申請のうち、判断基準を言葉にできるものの一覧づくりから始めてみてください。
よくある質問(FAQ)
Q1. Jevは無料で使えますか?
有料ですが、入力100万トークンあたり0.042ドルと安く、出力は無料です。Vercel AI Gatewayでは9月25日まで無料で使えると、Vercelが告知しています。新規登録で5ドル分のクレジットが付くとも報じられていますが、公式ページでは確認できていません。
Q2. Jevの読み方は?
公式は読み方を明示していません。国内の記事では「ジェブ」と「ジェヴ」が併用されています。名前は、経済学者ウィリアム・スタンレー・ジェヴォンズに由来します。
Q3. Jevは日本語でも使えますか?
使えます。ただし公式は、英語が最も精度が高く、日本語などは「対応するが同等ではない」としています。日本語の検証では高い一致率の報告が複数ありますが、件数は最大でも208件です。自社のデータで試してから使ってください。
Q4. Jevはハルシネーションしませんか?
「答えの形が必ず指定した型に合う」という意味では、起きません。公式ブログ自身が、この数字は実測値ではなく形の保証だと説明しています。選んだ答えは間違うことがあるため、確信度を見て人が確認する運用が要ります。
Q5. JevはChatGPTやClaudeの代わりになりますか?
代わりにはなりません。文章の作成や要約はできず、役割は判断に限られます。振り分けや一次判定をJevに任せ、文章が必要な部分をLLMに任せる、という分担が現実的です。
Q6. Jevを導入している企業はありますか?
企業名つきの本番導入事例は、2026年9月21日時点で確認できませんでした。確認できたのは、VercelやCloudflareなどの基盤への組み込み、LayerXの社内勉強会、第三者の検証、公開デモです。
Q7. 社内のデータを送っても大丈夫ですか?
公式は、顧客のリクエストと応答でモデルを訓練しないとしています。ゼロデータ保持はエンタープライズ向けに提供されています。なお、Jevはホスト型のAPIで自社のサーバーには置けません。個人情報や機密を送る場合は、データの保存場所を契約書類で確認し、社内の情報セキュリティ担当と検討してください。